



主流的AI CRM系统品牌
说实话,干这行久了,见过最让人头疼的系统,往往不是那种功能极其复杂的 ERP,而是看似简单的 CRM(客户关系管理)。为什么?因为 CRM 的核心是“人”,是动态的关系,而不是冷冰冰的库存数字。很多公司花大价钱买系统,或者自己招人开发,最后落得个销售不愿意用、老板看数不准的下场。归根结底,很多时候是底层的表设计没想明白。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
表设计是地基。地基打歪了,上面盖再漂亮的 UI,填再多的功能,最后都是危房。今天不聊那些虚头巴脑的理论,就结合我这些年踩过的坑,聊聊 CRM 表设计里到底有哪些核心要点。这玩意儿要是没弄好,后期重构的成本能让你怀疑人生。
CRM 表设计的第一道鬼门关,就是“客户是谁”。
听起来很简单,对吧?建个 customers 表,放个姓名、电话、公司,搞定。但实际业务里,这事儿能复杂到让你想砸键盘。销售 A 录入了一个“张三”,电话是 138xxxx;过了两个月,销售 B 又录入了一个“张三”,电话还是 138xxxx,但公司名写的是简称。系统里这就变成了两条数据。等到算业绩的时候,这客户到底算谁的?
所以,核心要点第一条:建立全局唯一的客户标识(Global Unique ID),并设计强大的合并机制。
在设计 customers 表时,主键别用业务字段,哪怕手机号也别直接当主键。一定要用 UUID 或者自增 ID 作为物理主键。但更重要的是,你需要一个逻辑上的“唯一身份识别”层。
我见过一种设计,是单独建一张 customer_identity 表。这张表里存各种标识符:手机号、微信号、邮箱、企业统一社会信用代码。每一个标识符都指向同一个 customer_id。当新数据进来时,先拿这些标识符去 customer_identity 里撞库。如果撞上了,就归并到现有客户;撞不上,才新建。
但这还不够。业务场景里还有“公海池”的概念。一个客户可能之前是 A 销售的,后来跟进了没成,掉回公海,又被 B 销售领走了。这时候,客户的基本信息可能变了(比如公司搬迁、联系人换人)。你的表结构里,得区分“静态基础信息”和“动态跟进信息”。
建议把 customers 表拆一下。一张表存核心档案(名称、行业、规模),这张表的数据变更频率低,权限控制严;另一张表存“跟进记录”或者“联系人快照”。为什么是快照?因为销售跟进的时候,客户那边的对接人可能换了。如果你只存一个当前的联系人 ID,历史跟进记录里的“当时对接人”就查不到了。所以,在 interaction_logs(跟进记录表)里,最好冗余一份当时的联系人姓名和电话。别怕冗余,在 CRM 里,历史场景的还原比范式化更重要。
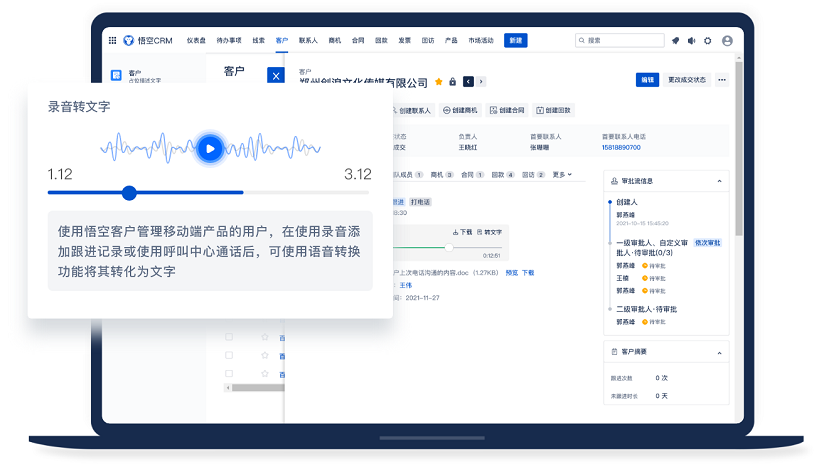
悟空CRM产品截图
很多初级设计者,把跟进记录(Interaction/Activity)设计成一张简单的表:id, customer_id, content, create_time。销售填个备注,存进去,完事。
这绝对是埋雷。
首先,跟进是有类型的。是电话?是拜访?是发邮件?还是微信聊天?不同类型的跟进,后续需要的处理逻辑完全不同。比如“电话”可能需要录音文件关联,“拜访”可能需要签到地理位置,“邮件”需要关联邮件原文 ID。如果你只用一个 type 字段区分,后期想加个“录音 URL"字段,就得改表结构,或者搞一堆 nullable 的列,看着就难受。
比较好的做法是,主表 activities 存通用信息(时间、类型、创建人、关联客户),然后针对特殊类型,设计扩展表。比如 activity_calls 存通话时长和录音,activity_meetings 存地点和参与人。或者,更现代一点的做法,直接用 JSON 字段存扩展属性。现在的数据库(像 PostgreSQL 的 JSONB 或 MySQL 5.7+ 的 JSON)性能已经很好了。
其次,跟进记录的查询频率极高。销售打开客户详情页,第一眼就要看最近的跟进记录。老板看报表,要统计销售每天打了多少电话。所以,activities 表的索引设计非常关键。customer_id + create_time 的联合索引是必须的。而且,考虑到数据量增长极快(一个活跃销售一天能产生几十条记录),这张表是 CRM 里最先爆表的。
这里有个经验之谈:冷热数据分离。 别指望一张表存 forever。设计的时候就要想好归档策略。比如,超过 2 年的跟进记录,自动迁移到 activities_history 表里。前端查询默认只查主表,用户点“查看更多历史”再去查历史表。这能保住你系统三年的流畅度。
CRM 的灵魂是销售漏斗(Sales Pipeline)。从“线索”到“商机”,再到“报价”、“合同”、“回款”。这个流程在表设计上怎么体现?
很多系统喜欢用一个大宽表,里面全是状态字段:lead_status, opportunity_status, contract_status... 这样设计耦合度太高了。线索和商机,在业务本质上其实是两个阶段的东西。线索可能是个模糊的信息,商机则是确认有预算、有需求的潜在交易。
我建议,线索(Leads)和商机(Opportunities)分表设计。
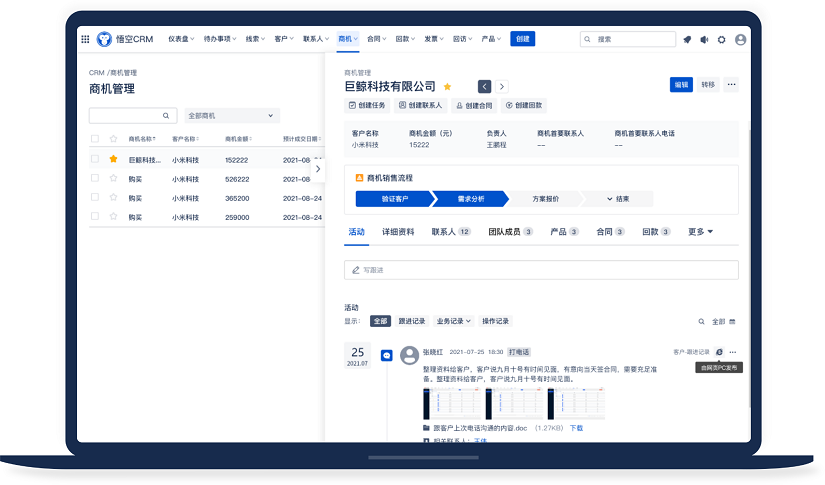
悟空CRM产品截图
leads 表结构要轻,主要为了快速录入和清洗。一旦线索转化成功,数据迁移到 opportunities 表,同时生成一条关联记录。opportunities 表才是重头戏。这里涉及到一个核心设计点:状态机(State Machine)的落地。
别只用一个 status 字段存“初步接触”、“需求分析”这种文本。最好设计一张 pipeline_stages 配置表,存阶段名称、顺序、赢单概率。商机表里存 stage_id。这样做的好处是,业务变了,销售流程从 5 步改成 7 步,你不用改代码,不用改表结构,只要在配置表里改改,前端渲染一下就行。
还有一个容易被忽视的点:输单原因。 很多设计里,商机结束了就结束了。但分析“为什么输单”对业务改进至关重要。在商机表里,或者关联的 opportunity_loss 表里,必须预留字段记录输单原因(价格太高?竞品介入?需求消失?)。这个字段最好是关联字典表的,方便后续做统计分析。
这是 CRM 开发里最痛苦的部分。业务部门今天说“我要记录客户的生日”,明天说“我要记录客户养的宠物类型”,后天说“这个字段只对华东区可见”。
如果你每加一个字段就 ALTER TABLE,DBA 会想砍人,系统也会锁表停机。所以,扩展性设计是 CRM 表设计的生死线。
传统的 EAV 模型(Entity-Attribute-Value)虽然灵活,但查询性能极差,join 起来能把你搞疯。现在比较推荐的方案是“主表 +JSON 扩展”或者“主表 + 垂直扩展表”。
比如,customers 表里有一个 custom_fields 列,类型是 JSON。所有的自定义字段都塞进去。查询的时候,如果数据库支持,可以直接对 JSON 里的 key 建索引。比如 PostgreSQL 的 GIN 索引,查起来飞快。
但要注意,JSON 方案虽然灵活,却牺牲了部分强类型约束。如果业务要求某个自定义字段必须必填,或者必须是数字,这就需要在应用层做校验,数据库层面很难控制。
主流的CRM系统品牌
还有一种场景是 SaaS 化的 CRM。多租户(Multi-tenancy)设计怎么搞?是在每张表里加个 tenant_id,还是分库分表?对于绝大多数中小企业 CRM,每张表加 tenant_id 是最稳妥的。 千万别为了所谓的“隔离性”去搞物理分库,除非你数据量真的到了亿级。所有的查询,务必在代码层或 ORM 层强制带上 tenant_id 条件,防止数据越权,这是安全红线。
CRM 里的数据是销售的命根子,也是公司的机密。权限设计不到位,要么销售撞单打架,要么核心客户资料泄露。
权限通常分两块:功能权限(能不能看这个菜单)和数据权限(能不能看这条数据)。表设计主要解决数据权限。
最基础的是“本人可见”。这好办,表里有个 owner_id(负责人 ID)。查询时加 WHERE owner_id = current_user。
复杂的是“部门可见”或“上级可见”。这时候,你的表结构里,光有 owner_id 就不够了。你需要一张 sys_dept 部门表,并且要在用户表里记录 dept_id 和 dept_path(部门路径,比如 1/5/12)。查询时,通过路径匹配来判断权限。
更细粒度的,是字段级权限。比如,普通销售能看到客户电话,但实习生只能看到脱敏后的号码(1380000)。这种需求,单纯靠数据库表设计很难完美解决,通常是在应用层做数据脱敏。但在表设计时,可以考虑把敏感字段(如手机号、身份证、银行卡)单独拆到一张 customer_sensitive_info 表里。这张表的访问权限控制得极严,普通查询不 Join 这张表,只有特定权限的接口才去查。这样从物理上就降低了一部分泄露风险。
刚上线的 CRM,数据量少,怎么查都快。等跑了一年,activities 表有了几百万条,customers 表有了几十万条,系统开始变慢,销售抱怨打开一个客户详情要转圈 5 秒。这时候再想优化,就是给飞行中的飞机换引擎。
所以,表设计之初就要有时间维度的考量。
activities、orders 这种按时间增长极快的表,直接按月份或年份做数据库分区。查询时带上时间范围,数据库会自动剪枝,只扫对应的分区,效率提升巨大。DELETE。CRM 里数据误删是高频事故。加个 is_deleted 字段,或者 deleted_at 时间戳。但要注意,所有查询都要带上 WHERE is_deleted = 0,这容易忘。可以在数据库层建视图(View),把过滤条件写死在视图里,应用层只查视图。activities 表里 count。但从性能角度,必须存。每次新增跟进记录,异步更新客户表里的这两个字段。这叫“空间换时间”。在 CRM 列表页,这种统计信息展示频率极高,实时计算会拖垮数据库。最后,再补充几个我在代码 Review 时经常揪出来的小问题,看似不起眼,实际很致命。
1. 时间字段的时区问题。
别存 varchar,别存时间戳(Unix Timestamp),尽量用数据库标准的 DATETIME 或 TIMESTAMP。而且,务必统一存 UTC 时间,或者统一存服务器所在时区时间。最忌讳的是,有的存北京时间,有的存 UTC,前端展示的时候还得猜。在表结构注释里写清楚:create_time (UTC)。
2. 金额字段的类型。
千万别用 FLOAT 或 DOUBLE 存钱!精度丢失会让你在财务对账时哭出来。用 DECIMAL(18, 4)。保留几位小数看业务,一般 4 位够用了。
3. 外键约束要不要加? 这是一个有争议的话题。理论上,加外键能保证数据一致性。但在高并发、分库分表的互联网架构下,外键是性能杀手,也是迁移的噩梦。我的建议是:CRM 系统内部,核心表之间(如客户与联系人)可以加外键,保证基础数据不脏。但在业务日志表、关联表上,尽量用应用层逻辑保证一致性,不要依赖数据库外键。 这样以后做数据归档、迁移,灵活性大很多。
4. 备注字段别设太短。
remark 或者 description 字段,别给个 varchar(255) 就完事。销售写起备注来,那是小作文。直接给 TEXT 类型。现在的数据库对 TEXT 的处理已经很好了,别为了省那点空间限制业务表达。
写了这么多,其实核心思想就一个:CRM 的表设计,不是为了满足数据库范式的洁癖,而是为了适应业务的流动。
客户是活的,销售流程是变的,数据量是涨的。一个好的 CRM 表结构,应该像水一样,能装进不同的容器里。它要能容忍一定程度的冗余,来换取查询的便捷;它要能预留足够的扩展空间,来应对明天的需求变更;它更要能守住安全的底线,不让数据成为漏洞。
很多时候,我们太迷信“标准设计”,却忘了问一线销售:“你平时最常用哪个字段?”“你最怕系统卡在哪里?”
如果你能拿着表结构图,跟销售总监聊半小时,他能挑出三个让你冷汗直流的场景,那你的设计才算刚入门。真正的好设计,是销售觉得系统“懂他”,老板觉得数据“可信”,而开发觉得“好维护”。
别把 CRM 做成“客户墓地”,只进不出,死气沉沉。让它成为业务的发动机,而这台发动机的缸体,就是你精心设计的每一张表。这活儿不性感,但绝对值回票价。下次动笔建表之前,多花点时间想想,这字段三年后还能用吗?这索引真的能命中吗?这权限真的安全吗?
想明白了这些,你的 CRM 系统,才算真正立住了。
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


