



主流的AI CRM系统品牌
干这行十几年,经手过不下十个 CRM 系统的重构与搭建,我最深的感触就是:CRM 的数据库设计,表面上看是存数据,实际上是在存“业务逻辑”和“人性”。很多刚入行的架构师,喜欢一上来就画 ER 图,把客户表、联系人表、订单表列得清清楚楚,觉得范式满足三范式就万事大吉了。结果系统上线不到半年,销售总监拍着桌子骂系统难用,数据查不出来,权限乱成一锅粥,最后只能推倒重来。
今天不想聊那些虚头巴脑的理论,就想结合这几年踩过的坑,实实在在聊聊 CRM 数据库结构到底该怎么设计,才能既扛得住业务增长,又不至于让开发团队天天加班修 Bug。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
一、别急着建表,先搞清楚是 B2B 还是 B2C
这是第一个大坑。很多设计文档里,客户表(Customer)就一张,觉得不管是对公还是对私,存进去不都是个名字加电话吗?大错特错。
如果你做的是 B2C,比如零售、教育 C 端,核心是“人”。数据库设计要围绕“用户 ID"展开,关注的是用户的行为轨迹、标签、消费记录。这时候,user_profile 表可能只需要存基础信息,大量的行为数据要丢进日志表或者大数据平台,MySQL 里只留热点数据。
但如果你做的是 B2B,比如 SaaS、企业服务,核心是“组织”。这时候,数据库的根基必须是“客户(Account)”和“联系人(Contact)”的分离。我见过最糟糕的设计,就是把联系人信息直接冗余在客户表里,用逗号分隔存多个手机号。这在查询时简直是灾难,更别说做权限控制了。
在 B2B 场景下,t_customer 表应该是核心资产。字段设计里,除了基础的名称、行业、规模,一定要预留 source(来源渠道)、level(客户等级)以及最重要的 owner_id(当前负责人)。这个 owner_id 是后续所有权限控制的根基。而 t_contact 表则通过 customer_id 关联,一个客户下可以有 N 个联系人,其中要标记一个 is_primary 字段,指明谁是关键决策人。
为什么非要分开?因为业务场景不同。销售跟进的是“客户”这个实体,但日常沟通、发邮件、打电话针对的往往是具体的“联系人”。如果不分开,当一家公司换了对接人,你难道要把整个客户记录的历史跟进记录都切断吗?分开设计,跟进记录(Follow-up Record)既可以关联客户,也可以关联具体联系人,灵活性高出不止一个量级。
二、公海与私海:权限设计的核心命门
CRM 系统最复杂的地方,从来不是存数据,而是谁能看数据。这直接关系到销售团队的利益分配。数据库设计里,必须把“公海池”和“私海池”的逻辑固化下来。
很多初级设计会加一个字段 status,0 代表私海,1 代表公海。这太 naive 了。真正的逻辑在于“领取”和“回收”。
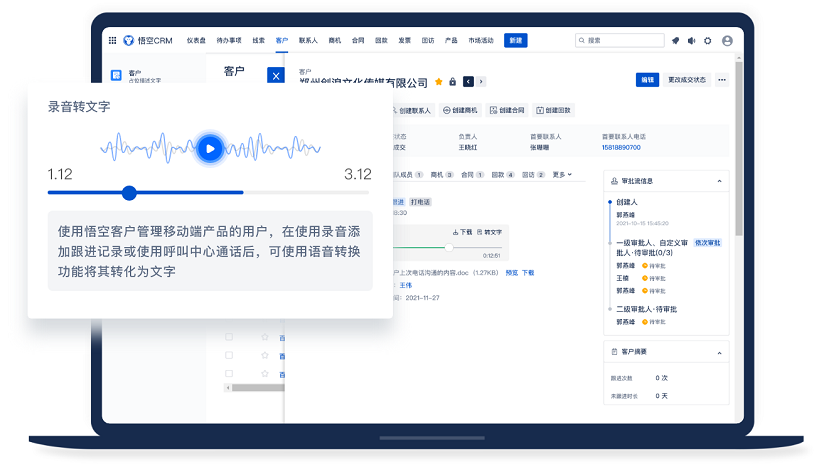
悟空CRM产品截图
你需要一张 t_customer_pool 或者直接在客户表里通过 owner_id 和 pool_id 来区分。我的建议是,在客户表里保留 owner_id,同时加一个 pool_type 字段。当 owner_id 为空或者特定值时,代表在公海。
但更关键的是“回收机制”的数据库支持。你不能靠定时任务去扫全表,那样数据量大了必死。需要在 t_follow_record(跟进记录表)里做文章。每次销售录入跟进记录,更新客户的 last_follow_time。数据库里要有一个视图或者索引,专门监控 last_follow_time 超过 N 天且 status 不是“已成交”的客户。
这里有个细节特别容易忽略:保护期。销售刚领走的客户,不能第二天就被回收。所以客户表里还得有 protect_until 字段。SQL 查询公海池的时候,条件就是:owner_id IS NULL OR (protect_until < NOW() AND last_follow_time < DATE_SUB(NOW(), INTERVAL 30 DAY))。这种逻辑如果不在数据库设计阶段想清楚,后期靠代码硬补,性能会非常难看。
另外,关于数据权限,不要试图在代码里写 if (user.role == 'admin')。最好的方式是在数据库查询层面做拦截。比如每个数据行都带上 dept_id(部门 ID)和 create_user_id。查询时,根据当前用户的角色,动态拼接 WHERE 条件。如果是普通销售,只能查 owner_id = current_user_id;如果是销售总监,查 dept_id = current_user_dept_id。这种数据隔离的设计,必须在建表时就规划好字段,后期加字段改历史数据,那是运维的噩梦。
三、跟进记录:别只用一张表
跟进记录是 CRM 里数据量增长最快的表。销售每天打电话、写备注、上传附件,这张表很快就会突破千万级。
很多设计初期只建一张 t_activity 表,把所有类型的跟进(电话、邮件、拜访、笔记)都塞进去,用一个 type 字段区分。刚开始没问题,等业务复杂了,你会发现不同跟进类型需要的字段完全不同。电话需要录音 URL 和时长,拜访需要签到地点和照片,邮件需要主题和往来内容。
这时候,要么 t_activity 表里一堆 nullable 字段,浪费空间且难看;要么就得搞继承表结构。我的经验是,采用“主表 + 扩展表”或者直接用 JSON 存储差异化字段。
在 MySQL 5.7 之后,我强烈建议用 JSON 类型存扩展内容。主表 t_follow_up 存通用的 customer_id, user_id, follow_time, type, content_summary。具体的详情,比如录音地址、签到坐标,丢进一个 ext_info 的 JSON 字段里。这样既保证了核心查询走索引(在 customer_id 和 follow_time 上建联合索引),又保留了扩展性。
千万别搞 EAV 模型(Entity-Attribute-Value),就是那种 table_name, field_name, value 的三列式设计。在 CRM 这种高并发读取的场景下,EAV 模型查询起来需要多次自连接,性能极差,而且没法用索引优化。除非你有极其特殊的动态表单需求,否则别碰 EAV。
四、自定义字段:业务方的永恒需求
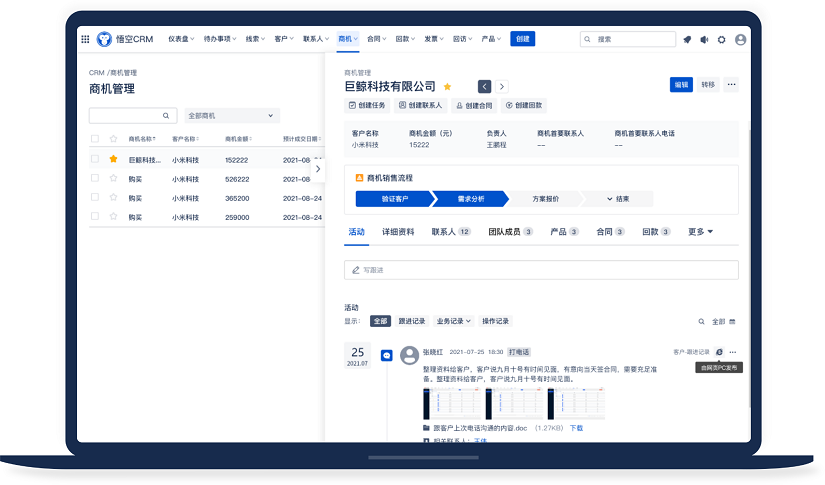
悟空CRM产品截图
做 CRM 的,肯定会被业务方问:“能不能给客户表加个字段,我们要记‘竞争对手’?”“能不能给联系人加个‘生日’?”
如果每次需求都让 DBA 加字段,数据库迟早崩。所以,设计之初就要考虑“自定义字段”的存储方案。
目前主流有两种路子。一种是垂直表扩展,预留 ext_field_1 到 ext_field_10。这太蠢了,不够用且没语义。另一种是元数据驱动。建一张 t_field_definition 存字段定义(字段名、类型、所属模块),再建一张 t_field_value 存具体值(对象 ID、字段 ID、值)。
前面说了,t_field_value 这种 EAV 模式查询性能差。现在的最佳实践是:在核心表里直接加一个 custom_fields 的 JSON 列。业务配置自定义字段时,只是配置元数据,实际数据以 Key-Value 形式存在 JSON 里。查询时,利用 MySQL 的 JSON 提取函数,比如 WHERE custom_fields->'$.competitor' = 'A 公司'。虽然比原生列稍微慢点,但换来了极大的灵活性,而且不需要频繁 DDL 操作,对线上库更友好。
五、数据清洗与合并:被忽视的隐形成本
系统运行一段时间后,必然会出现重复客户。销售 A 录入了“腾讯科技”,销售 B 录入了“腾讯科技有限公司”。数据库里成了两条记录,跟进记录分散,业绩算不准。
所以,数据库设计里要预留“合并”的接口支持。不要物理删除重复数据!千万不要!
正确的做法是引入 merge_from_id 和 is_deleted(逻辑删除)。当发生合并时,保留一条主数据,将另一条数据的 is_deleted 标记为 1,并记录 merge_to_id 指向主数据。所有的关联表(如跟进记录、合同、回款),在查询时,不仅要查 customer_id,还要查 merge_from_id 指向该 ID 的记录。
这听起来很麻烦,但这是保证数据完整性的唯一办法。如果你直接物理删除了那条重复客户,它名下的历史跟进记录就成孤儿数据了,以后审计查起来,根本不知道当初是谁跟进了这个客户。
主流的CRM系统品牌
为了支持这种查询,可以在关联表里做一个冗余字段 root_customer_id。在客户合并时,批量更新关联表的 root_customer_id。虽然写入时麻烦点,但读取时只需要查一个 ID,性能提升巨大。CRM 系统是读多写少的场景,优化读取体验是第一位的。
六、操作日志:出了事谁背锅
CRM 里存的都是公司的核心资产,客户电话、成交金额,这些都是敏感数据。谁修改了客户电话?谁导出了客户列表?谁把公海客户私自领走了?
这些不能靠代码里随便打点日志,必须有一张独立的 t_operation_log 表。这张表的设计要“宽”且“不可篡改”。
字段至少包括:operator_id(操作人)、operate_time(时间)、module(模块)、action(动作)、target_id(目标数据 ID)、before_value(修改前值)、after_value(修改后值)、ip_address(IP)。
注意,before_value 和 after_value 最好存 JSON 快照。因为你可能不知道未来会对比哪个字段。这张表数据量会非常大,建议按月分表,或者定期归档到冷存储。但在设计初期,一定要加上索引,至少要有 target_id 和 operator_id 的索引,否则查某个客户的修改记录时,全表扫描会让你怀疑人生。
七、性能与扩展:为未来留条路
最后聊聊性能。CRM 系统最容易卡的地方,通常是“客户列表页”。销售要筛选:行业是互联网、地区是北京、最近 30 天有跟进、等级是 A 类。
这种多条件组合查询,普通的 B-Tree 索引很难覆盖。如果数据量在百万级以内,MySQL 还能扛。一旦过千万,必须考虑搜索引擎。
在设计数据库结构时,就要考虑到未来可能同步到 Elasticsearch。这意味着,你的数据库字段类型要规范,不要存奇怪的分隔符字符串。比如标签,别存 "1,2,3",要么用关联表 t_customer_tag_rel,要么存 JSON 数组。这样同步到 ES 时,才能方便地做聚合查询。
另外,关于读写分离。CRM 的写操作集中在销售录入,读操作集中在管理层看报表。在数据库设计时,尽量保证核心交易链路(录入、转化)和报表分析链路(统计、大屏)的数据分离。可以通过 Binlog 同步到数仓,别让复杂的统计 SQL 拖垮了在线交易库。
还有一点,软删除(Soft Delete)几乎是标配。所有核心业务表,必须加 is_deleted 和 delete_time。不要相信“备份恢复”,业务人员手滑删错数据是常态,数据库层面留一手,能救运维的命。
八、写在最后的话
说了这么多,其实 CRM 数据库设计没有标准答案,只有最适合当前业务的答案。
我见过最成功的设计,往往不是技术最先进的,而是最懂业务的。比如,有的公司销售流程特别复杂,需要把“商机(Opportunity)”拆分成多个阶段,每个阶段对应不同的必填字段。这时候,数据库里就需要一张 t_sales_stage 配置表,来驱动前端表单的渲染,而不是把字段写死在代码里。
设计数据库时,多去跟销售聊聊天,问问他们平时怎么记笔记,怎么查客户,怎么算业绩。你会发现,他们随口抱怨的一句“查个数据太慢了”,背后可能就是一个缺失的联合索引;他们抱怨的“这个客户明明是我的”,背后可能就是 owner_id 的转移逻辑没闭环。
技术是为业务服务的。CRM 数据库结构的设计,本质上是在平衡“数据规范性”与“业务灵活性”。太规范,业务动不了;太灵活,后期就是技术债。
我的建议是,核心实体(客户、联系人、商机)的字段要稳,尽量符合范式;扩展属性(标签、自定义信息、跟进详情)要活,善用 JSON 和关联表;权限与日志要严,这是系统的底线。
别想着一次设计完美。数据库是演进的,预留好扩展字段,写好迁移脚本,保持对数据的敬畏之心。毕竟,代码写错了可以重构,数据搞丢了,那可就真的没法向老板交代了。这行干久了你就会明白,一个好的数据库结构,是能让后来维护的人,在深夜加班时少骂几句娘的设计。
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


