



主流的AI CRM系统品牌
提起 CRM(客户关系管理)系统的架构设计,很多刚入行的产品经理或者技术负责人,第一反应往往是画几张漂亮的拓扑图,罗列一堆微服务、数据库、API 网关之类的术语。但真正做过几个大型 CRM 落地项目的人心里都清楚,架构设计从来不是单纯的技术堆砌,而是一场关于业务逻辑、数据流转和人性的博弈。
我见过太多 CRM 项目死在“架构过于完美”上。为什么?因为设计者太迷恋技术的先进性,却忽略了销售人员在外面跑业务时,网络可能只有 3G,手机可能电量不足,或者他们根本不愿意多填一个字段。所以,当我们谈论 CRM 体系结构如何设计时,不能只盯着代码和服务器,得先聊聊这玩意儿到底是给谁用的,又要解决什么核心矛盾。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
一、核心逻辑:是管理工具,还是赋能武器?
在动笔写第一行架构文档之前,必须明确一个定位:这个 CRM 是用来“管”销售的,还是用来“帮”销售的?
传统的架构设计思路,往往偏向于管控。数据录入要严谨,审批流程要闭环,权限控制要细颗粒度。这种思路下的架构,通常是一个严密的漏斗模型,数据从顶端流入,层层过滤,最后沉淀在老板的报表里。但这种架构有个致命弱点:一线人员觉得它是负担。如果架构设计只考虑了管理层的视角,忽略了执行层的体验,系统上线之日就是数据造假开始之时。
现在的 CRM 架构设计,更倾向于“赋能”。这意味着架构的灵活性要极高。比如,在业务逻辑层,不能写死流程。今天的销售流程可能是“线索 - 商机 - 报价 - 合同”,明天可能因为业务调整变成了“线索 - 拜访 - 样品 - 合同”。如果架构不支持动态配置工作流,每次业务变动都要改代码、发版,那这个系统寿命超不过半年。
因此,在设计之初,我就习惯在架构里预留一个“流程引擎”层。这不是简单的状态机,而是要支持可视化拖拽配置的状态流转。这听起来是功能需求,其实是架构决策。它决定了你的业务逻辑层是硬编码的“铁板”,还是可插拔的“积木”。
二、分层架构的实战演变
教科书上喜欢讲经典的三层架构:表现层、业务逻辑层、数据访问层。但在企业级 CRM 的实际设计中,这套理论早就不够用了。现在的主流设计,更像是一个“前 - 中 - 后”台的协同体系。
1. 前端:多端适配与离线能力
表现层早就不是简单的 Web 页面了。销售在外用企业微信或钉钉,内勤用 PC 端,管理层看大屏。架构设计必须考虑多端统一。这里有个坑,很多团队为了省事,直接搞一套 H5 套壳。但 CRM 对交互要求很高,比如地图打卡、名片 OCR 识别、语音转文字,这些原生能力 H5 支持得并不好。
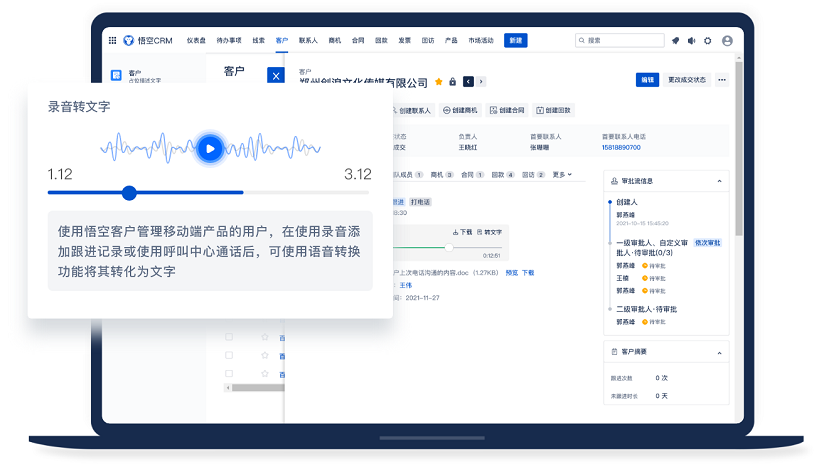
悟空CRM产品截图
所以,比较稳健的架构是“核心 Web 端 + 原生小程序/APP 混合”。在架构上,这意味着前端需要有一个统一的 BFF(Backend for Frontend)层。这个层专门负责聚合数据,适配不同终端的展示需求。比如,手机端只需要显示客户名称和电话,而 PC 端需要显示完整的跟进记录和分析图表。如果没有 BFF,后端接口就得为了迁就手机端返回冗余数据,或者为了 PC 端搞一堆复杂的关联查询,性能会崩。
另外,离线能力是 CRM 架构的试金石。地下室、高铁上、偏远厂区,网络信号是不稳定的。架构设计时,本地数据库(如 SQLite 或 Realm)是必须的。数据同步机制要设计成“队列 + 冲突检测”。当网络恢复时,本地操作队列自动上传。如果同一客户在本地和服务器都被修改了,怎么解决冲突?是“最后写入优先”,还是“弹窗让人工选择”?这不仅是技术问题,更是业务规则问题。我在设计时,通常会在数据模型里加一个 version 字段,配合时间戳,在中间件层处理大部分冲突,实在解决不了的再抛给前端提示用户。
2. 中台:业务能力的沉淀
“中台”这个词虽然被用滥了,但在 CRM 架构里,它确实解决了重复造轮子的问题。CRM 的核心能力是什么?是客户中心、商机中心、活动中心、产品中心。
把这些能力沉淀为微服务,是架构的必然选择。但微服务不是拆得越细越好。我见过把“客户创建”和“客户修改”拆成两个服务的,结果事务一致性处理得让人头大。合理的拆分应该是按领域驱动设计(DDD)来。比如“客户域”,它包含了客户的基本信息、联系人、关联公海池规则等。这个域内的数据强一致性,必须在一个事务里。而“客户域”和“订单域”之间,则是最终一致性,通过消息队列(如 Kafka 或 RocketMQ)来解耦。
在中台层,还有一个关键设计是“规则引擎”。销售提成怎么算?客户公海池怎么回收?这些规则变动极快。如果把规则写死在代码里,运维会疯掉。架构上需要引入 Drools 或者自研的脚本引擎(如 Lua 或 JavaScript 沙箱),让业务人员能在后台配置规则,系统实时生效。这大大降低了架构的耦合度。
3. 后台:数据的稳定与合规
后台主要是数据存储和基础支撑。CRM 的数据是企业的命脉,架构设计的重中之重是安全与备份。
数据库选型上,关系型数据库(MySQL/PostgreSQL)依然是主力,因为客户数据的关系复杂,事务要求高。但随着数据量增大,单表过千万是常态。这时候架构就要考虑分库分表。是按客户 ID 哈希分,还是按时间分?通常建议按租户 ID(如果是 SaaS)或区域 ID 分,这样能保证大部分查询落在一个库内。
除了结构化数据,CRM 还有大量的非结构化数据:通话录音、聊天截图、合同 PDF。这些不能直接塞进数据库,得对象存储(如 OSS 或 S3)。架构上要设计好索引,把文件 URL 存在数据库里,文件本身存在存储桶里,并通过 CDN 加速访问。
三、数据架构:打通孤岛的血脉
悟空CRM产品截图
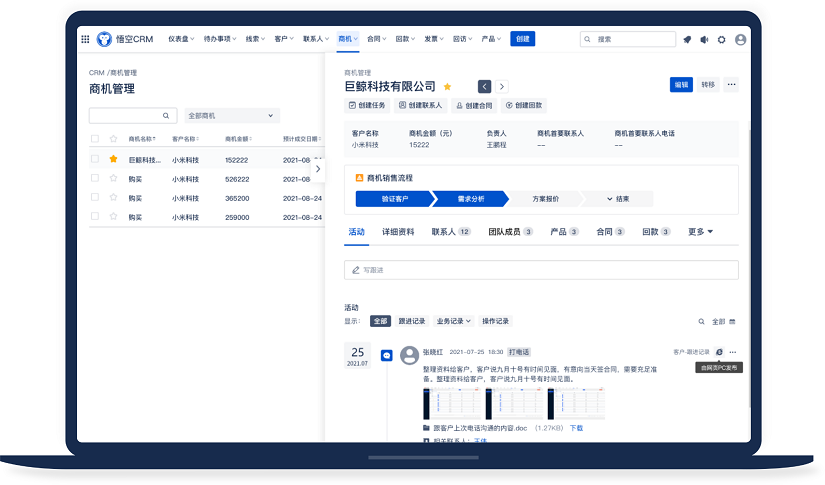
CRM 最怕变成信息孤岛。销售在 CRM 里,财务在 ERP 里,客服在工单系统里,市场在营销自动化里。如果架构设计时没考虑集成,最后就是数据打架。
1. 集成架构:API First
现在的 CRM 架构必须是 API First 的。所有核心功能,必须先有 API 接口,再有界面。这样,当 ERP 需要读取客户信用额度时,直接调 API 就行,不用去读数据库。
为了管理这些接口,API 网关是标配。它负责鉴权、限流、日志记录。我建议在网关层就做一层数据脱敏。比如,普通销售调用客户接口,手机号中间四位自动掩码;只有经理权限才能看到完整号码。这种安全控制下沉到网关,比在每个微服务里写一遍要安全得多,也统一得多。
2. 数据仓库与 BI
交易型数据库(OLTP)不适合做复杂分析。当销售想看看“过去三年华东区季度复购率”时,直接查业务库会把 CPU 打满。架构上需要建立 ETL 流程,把数据同步到数据仓库(如 ClickHouse 或 Snowflake)。
这里有个细节:实时性。老板可能希望看板是实时的。全量 T+1 同步不够用。架构上可以采用 CDC(Change Data Capture)技术,监听数据库的 Binlog,一旦有订单变更,毫秒级同步到数仓。这样,大屏上的数字才是跳动的,而不是昨天的旧闻。
3. 主数据管理(MDM)
这是最头疼的部分。同一个客户,在市场部叫“腾讯科技”,在销售部叫“深圳腾讯”,在财务那叫“腾讯控股有限公司”。如果不做清洗,报表里的客户数就是虚的。
主流的CRM系统品牌
架构设计里必须有一个 MDM 模块,或者至少有一套合并规则。当新线索进入时,系统通过企业名称、税号、手机号等关键字段进行模糊匹配。如果相似度超过阈值,提示“疑似重复”,让人工确认合并。这个逻辑要放在数据接入层,脏数据不进池子。
四、权限体系:比想象中更复杂
很多初学者觉得权限就是 RBAC(基于角色的访问控制)。给销售一个角色,给经理一个角色,完事。但在 CRM 里,这远远不够。
CRM 的权限是三维的:功能权限(能不能看这个菜单)、数据权限(能不能看这个客户)、字段权限(能不能看手机号)。
特别是数据权限,架构设计要支持“行级过滤”。比如,上海区的销售,查询客户表时,SQL 背后自动加上 WHERE region = 'Shanghai'。这个过滤逻辑不能写在每个 Service 里,否则漏一个就出事故。最好的方式是在数据库中间件层,或者 MyBatis 的拦截器层,统一注入过滤条件。
还有“公海池”机制。客户如果销售跟进不及时,要掉回公海,让别人抢。这涉及到定时任务和状态变更。架构上不能用简单的 Cron 轮询,数据量大时会锁表。建议用时间轮算法或者延迟队列,客户创建时就把“回收时间”扔进队列,时间到了触发回调,把所有权释放。
五、扩展性与低代码趋势
现在的企业业务变化太快,今天做零售,明天可能转批发。CRM 架构如果不够灵活,就是累赘。
1. 自定义字段与对象
标准的 CRM 有客户、商机表。但企业往往需要记录“客户偏好”、“行业属性”等特有信息。架构上要支持 EAV 模型(Entity-Attribute-Value)或者利用 NoSQL(如 MongoDB)存储扩展属性。不过 EAV 模型查询性能差,我的建议是:核心字段用关系型数据库,扩展字段用 JSON 格式存在一个大字段里,或者单独存文档库。查询时,常用扩展字段建立倒排索引。
2. 低代码平台集成
未来的 CRM 架构,一定包含低代码能力。允许实施人员通过拖拽生成简单的表单和流程。这意味着架构底层要有一个“元数据驱动”的引擎。前端渲染不是写死的 HTML,而是根据后端下发的 JSON 配置动态生成表单。这增加了前端开发的复杂度,但换来了业务的敏捷性。
六、安全与合规的底线
设计架构时,安全往往是被牺牲的,直到出事。
1. 数据加密
敏感字段(手机号、身份证、银行卡)在数据库里必须加密存储。不要只依赖传输层 HTTPS。架构上要封装一个加解密组件,业务代码无感调用。密钥管理要独立,不能和代码放在一起。
2. 操作审计
谁在什么时候导出了客户数据?谁修改了合同金额?这些操作必须留痕。架构上建议使用 AOP(面向切面编程),在关键方法上打注解,自动记录操作日志到独立的审计库。这个库只能由合规人员访问,普通 DBA 都不能删。
3. 多租户隔离(针对 SaaS)
如果是 SaaS 版 CRM,租户隔离是架构基石。有三种方案:独立数据库、独立 Schema、共享表加 TenantID。 独立数据库最安全,成本最高;共享表成本最低,但有数据泄露风险。目前主流折中方案是共享 Schema,独立表前缀,或者严格依赖 TenantID 过滤。无论选哪种,架构代码里绝对不能出现硬编码的 TenantID,必须从上下文(Context)里自动获取,防止越权访问。
七、避坑指南:那些血泪换来的经验
说了这么多理论,最后分享几个实际落地中容易踩的坑,这些往往是架构文档里不会写的。
第一,别高估用户的录入意愿。架构设计再完美,如果录入成本太高,系统就是空的。尽量利用技术手段减少录入。比如,打通企业微信,聊天记录自动归档;打通电话系统,通话自动关联客户;甚至用 AI 自动提取名片信息。架构上要预留这些外部系统的 Hook 点。
第二,别低估历史数据的迁移难度。新系统上线,旧系统的数据怎么迁?字段映射、数据清洗、去重,这工作量往往占项目的 40%。架构设计时要提供“导入 - 清洗 - 预览 - 确认”的标准流程工具,不要指望写脚本一次性搞定。
第三,性能瓶颈往往在报表。销售总监最喜欢看复杂的透视表。架构上要做读写分离,报表查询走从库,甚至走专门的 ES(Elasticsearch)集群。别让一个复杂查询把交易库拖垮,导致销售没法开单。
第四,移动端体验决定生死。如果手机端打开一个客户详情需要 5 秒,销售就会弃用。架构上要做好缓存策略,热点数据(如常用客户列表)缓存在 Redis 里,甚至缓存在本地。
八、结语:架构是长出来的,不是画出来的
回到最初的问题,CRM 体系结构是如何设计的?
它不是坐在办公室里画出来的 Visio 图,而是在一次次业务冲突、性能报警、用户吐槽中迭代出来的。一个好的 CRM 架构,应该是“湿润”的,它带着业务的温度,理解销售的难处,包容数据的不完美。
它既要有坚硬的骨架,保证数据不丢、权限不乱、系统不崩;又要有柔软的血肉,能适应流程的变更、字段的扩展、集成的需求。
在设计时,我们常常纠结于选什么数据库、用什么框架。其实,技术选型只是战术,业务理解才是战略。如果你不懂销售是怎么谈单的,不懂财务是怎么核销的,不懂客服是怎么处理投诉的,那么无论你用了多先进的微服务架构,多炫酷的前端技术,做出来的 CRM 依然只是一个昂贵的电子表格。
真正的架构师,在写代码之前,会先去跟销售跑两天客户,去听听他们在路上抱怨什么。因为最好的架构设计,往往就藏在这些抱怨里。他们抱怨网不好,你就做离线同步;他们抱怨填表烦,你就做 OCR 识别;他们抱怨流程慢,你就做移动端审批。
CRM 系统的终极目标,不是管理,而是连接。连接企业与客户,连接数据与决策,连接战略与执行。架构设计,就是为这些连接搭建最稳固、最高效的桥梁。这座桥,既要经得起高并发的流量冲击,也要经得起漫长岁月的业务变迁。
所以,下次当你准备设计 CRM 架构时,先别急着打开 IDE。问问自己:这个设计,能让销售少打一个电话吗?能让老板少看一张假报表吗?如果能,那这就是一个好架构的开始。剩下的,不过是技术实现的细节罢了。在这个数字化转型的深水区,我们需要的不是最完美的技术架构,而是最懂人性的业务架构。这,或许才是 CRM 体系设计的真正核心。
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


