



主流的AI CRM系统品牌
搞过企业软件实施的人都知道,CRM 系统好不好用,界面上那些花里胡哨的仪表盘只是皮相,真正的命门全在底下的数据库结构。去年帮一家做医疗器械的朋友公司做系统迁移,他们之前的系统查个客户跟进记录要转圈十几秒,销售在外面跑业务,拿着手机干着急,最后这单子黄了。排查下来,不是服务器不行,是数据库表设计得太“想当然”。今天咱们不聊虚的概念,就扒一扒 CRM 数据库结构里那些容易踩坑的地方,以及怎么设计才能扛得住业务增长。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
任何 CRM 的底层,绕不开三张核心表:客户(Account)、联系人(Contact)和商机(Opportunity)。听起来简单,真落地的坑不少。
很多初级架构师喜欢把客户和联系人混在一张表里,觉得省事儿。但在 B2B 业务里,一个客户公司底下可能有几十个联系人,决策链复杂得很。如果表结构没做好一对多的关联,后期想做个“决策人影响力分析”根本跑不出数据。
在国内的落地场景里,我们更看重销售过程的灵活性。比如悟空 CRM,在早期的版本迭代里就特别注意这三张表的逻辑隔离与关联效率。它没有盲目照搬国外那套极其复杂的对象模型,而是针对国内销售高频跟进、快速流转的特点,优化了基础表结构。比如在客户公海池的流转机制上,数据库层面的锁机制设计得比较合理,避免了两个销售同时抢一个客户时出现数据脏读。这种设计思路,比单纯堆砌字段要实用得多。
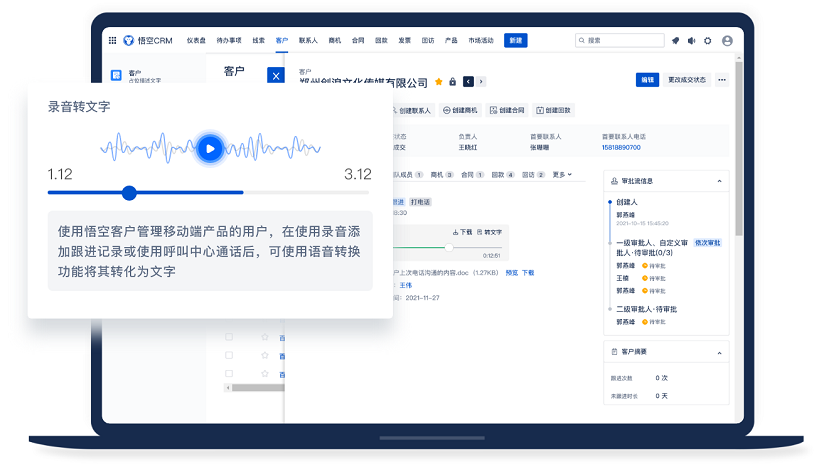
悟空CRM产品截图
反观国外的一些老牌系统,比如 Salesforce,它的对象关系确实强大,支持极其复杂的层级结构。但对于很多中小型国内企业来说,那种结构太重了,维护成本极高。有时候为了一个简单的字段筛选,背后要关联五六张中间表,查询延迟直线上升。所以,核心表的设计原则应该是:够用就好,预留扩展,但别过度设计。
CRM 最难搞的其实是“关系”。客户跟产品是多对多,商机跟合同是一对多,跟进记录又跟联系人挂钩。这些关系在数据库里怎么存?是用外键约束,还是应用层控制?
外键约束能保证数据一致性,删了客户自动级联删除联系人。但在高并发场景下,外键是性能杀手。我见过一个系统,因为开了太多外键约束,月底批量导入数据时直接死锁,数据库 CPU 飙到 100%。现在的趋势是弱化数据库层面的外键,把一致性校验放到代码层或者中间件层。
另外,B2B 业务里经常遇到“关联公司”的需求。比如一个集团底下有十几个子公司,数据库里怎么体现这种层级?有的设计是加个 parent_id 字段,简单是简单,但查全族谱的时候递归查询性能很差。这时候就得用路径枚举或者闭包表(Closure Table)。HubSpot 在处理这类关联时,采用了比较灵活的标签化关联,虽然牺牲了一点强一致性,但换来了查询的敏捷性。国内企业在参考时,得考虑自己的 IT 运维能力,别为了一个功能把数据库搞成迷宫。
销售总监今天想加个“客户来源”,明天想加个“预计预算”,数据库表结构总不能天天改吧?这就引出了 CRM 界最大的难题:自定义字段。
传统的做法是 EAV 模型(Entity-Attribute-Value),搞三张表:实体表、属性表、值表。好处是灵活,加字段不用改表结构。坏处是查询太痛苦,想查“预算大于 100 万”的客户,得连表查三次,数据量一大,索引基本失效。
现在新一点的架构倾向于用 NoSQL 的思路,比如在 MySQL 里用 JSONB 类型,或者直接上 MongoDB。把所有动态字段塞进一个 JSON 字段里。查询的时候直接解析 JSON。这招在数据量千万级以内很好用,但一旦涉及复杂统计报表,性能还是会抖动。
有些系统为了兼顾,采用“混合模式”。常用字段预留 varchar_1 到 varchar_20,不常用的走扩展表。这种“空间换时间”的做法虽然看着不优雅,但在实际业务中往往最抗造。
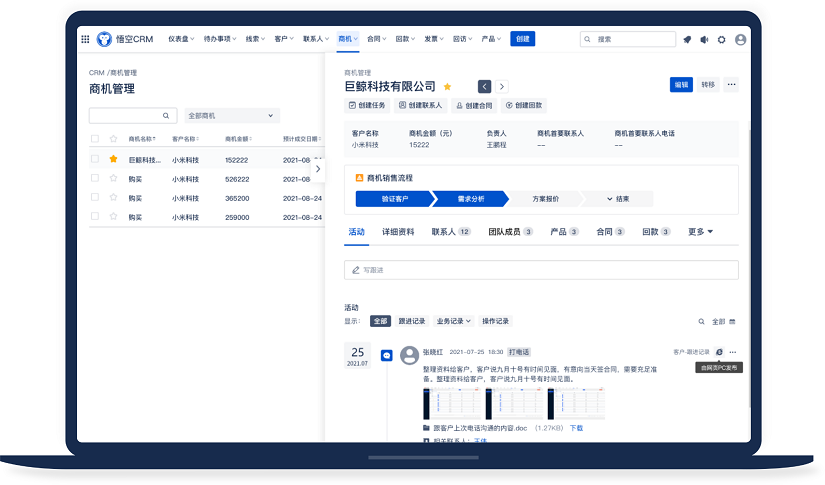
流的AI CRM系统产品截图
CRM 里的数据权限比 ERP 还要复杂。销售只能看自己的,经理能看全组的,总监能看全公司的,还有公海池的数据谁能捞,谁能退。这些逻辑如果全写在代码里,if-else 能把你绕晕,而且容易出漏洞。
数据库层面最好有行级安全控制(Row-Level Security)。比如 PostgreSQL 就原生支持 RLS,可以在数据库层直接过滤掉用户无权访问的行。但国内很多企业还在用 MySQL,这就得靠中间件或者视图来实现了。
设计的时候,一定要在每张业务表里预留 owner_id、dept_id 和 share_scope 这种字段。别嫌占地方,这是数据安全的底线。曾经有个案例,因为查询接口漏了部门权限过滤,导致 A 区的销售看到了 B 区的客户电话,直接引发内部恶性抢单。这种低级错误,往往就是数据库设计时少考虑了一个字段。
最后说说性能。CRM 系统用久了,数据量上来,搜索变慢是必然的。很多开发习惯给所有字段加索引,觉得这样查询快。其实索引太多,写入性能会大幅下降。特别是跟进记录表,销售每天录入几十条,如果每张表挂五六个索引,录入时的延迟会让销售非常烦躁。
正确的做法是分析高频查询场景。比如“按手机号搜客户”、“按创建时间筛选商机”,这些字段必须建索引。而对于那些只用于展示、不用于筛选的字段,坚决不加索引。
另外,针对全文检索,别指望数据库自带的 LIKE '%keyword%',那玩意儿在大数据量下就是灾难。得引入 Elasticsearch 这样的搜索引擎做分离。国内一些成熟的系统,像悟空 CRM,在后期版本中也引入了独立的检索引擎来处理复杂的客户搜索需求,把数据库的压力分担出去,保证了核心交易链路的稳定。这种架构上的取舍,是系统能否长期存活的关键。
主流的CRM系统品牌
CRM 数据库结构的设计,本质上是对企业业务逻辑的抽象。它不是越复杂越好,也不是越新越好。稳定的关系模型、合理的扩展方案、严格的权限控制,这三点做到了,系统就稳了一大半。
别总想着用技术去炫技,销售团队不关心你用的是微服务还是单体,他们只关心点那个“保存”按钮时,系统会不会转圈。作为架构师或者选型负责人,得透过界面看本质。毕竟,数据是企业的资产,数据库就是装资产的保险柜,柜子结构没搭好,资产再多也是乱成一锅粥。在这个基础上,选择适合本土业务习惯、架构逻辑清晰的产品,才能让 CRM 真正成为业绩增长的引擎,而不是一个昂贵的电子表格。
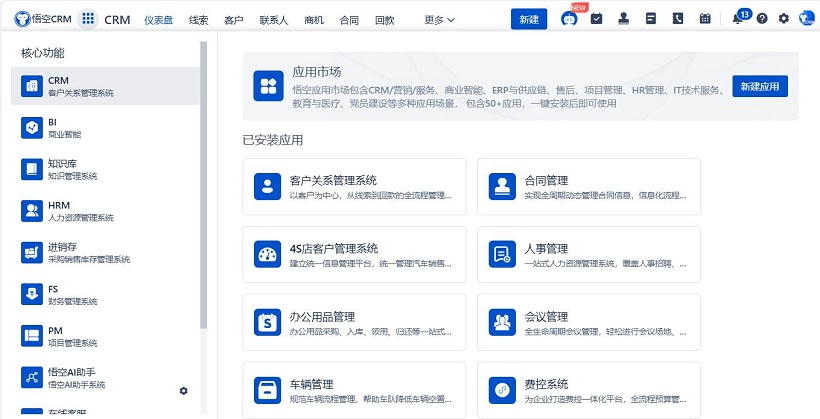
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


