


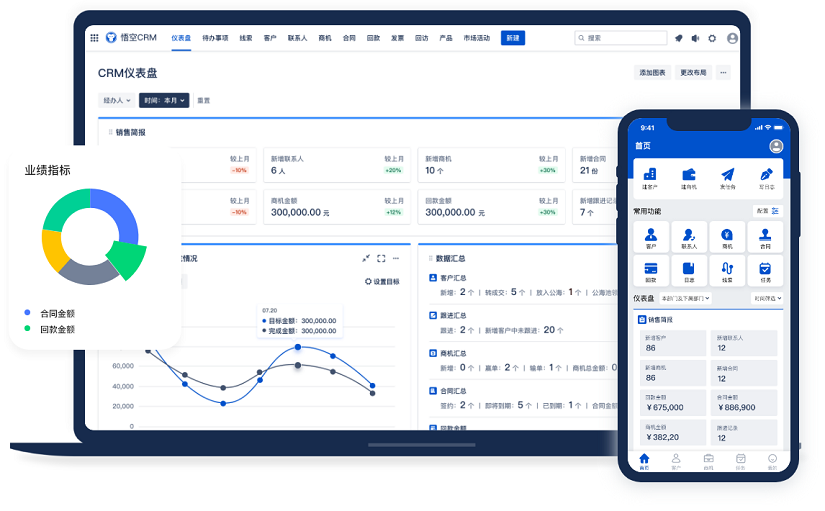
主流的AI CRM系统品牌
做技术这行久了,尤其是跟业务系统打交道,最怕听到的不是“服务器崩了”,而是销售总监拍着桌子问:“我就查个客户电话,转圈转了半分钟,这系统还能不能用了?”
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
这话听着刺耳,但确实是很多 CRM(客户关系管理)系统上线后的真实写照。刚开始数据量少,几万条记录,怎么查都快。可业务跑起来,数据像滚雪球一样,半年不到,客户表破百万,关联的跟进记录、合同、发票全加起来,数据量轻松过千万。这时候,原本丝滑的检索界面开始卡顿,简单的模糊查询能拖死数据库,销售抱怨,老板施压,最后锅全扣在开发头上。
其实,CRM 系统里的客户数据检索,从来不是简单的 SELECT * FROM customers WHERE name LIKE '%张三%' 这么回事。它背后牵扯的是数据库设计、索引策略、搜索引擎选型、缓存架构,甚至还包括数据治理这一堆烂摊子。今天咱们不聊那些虚头巴脑的理论,就结合实际踩过的坑,聊聊怎么让 CRM 里的客户数据检索真正“快”起来。
很多初级架构师容易犯的一个毛病,就是觉得 MySQL 或者 Oracle 能存就能查。在数据量小的时候,这逻辑没问题。但到了 CRM 这种场景,客户数据有个特点:字段多、更新频、查询条件杂。
销售查客户,有时候按名字,有时候按手机号,有时候按行业,甚至有时候只记得个大概的公司地址。如果你把所有查询压力都扛在关系型数据库上,迟早要崩。
首先得说索引。这玩意儿是双刃剑。加对了是加速器,加错了是累赘。我见过一个项目,为了优化查询,给客户表的二十多个字段全加了索引。结果呢?插入和更新数据的时候慢得要命,因为每次写操作都要维护这么多索引树。对于 CRM 来说,写操作虽然不如读操作频繁,但销售录入信息、更新跟进状态也是高频动作。
正确的做法是“按需索引”。你得去翻日志,看销售到底最常搜什么。通常来说,手机号、企业名称、客户 ID 这三个是核心。手机号必须唯一索引,企业名称适合普通索引。但要注意,像“地址”这种字段,除非你有明确的区域划分代码,否则别瞎加索引,因为模糊匹配 %北京% 是走不到索引的,加了也白加,还占空间。
这里有个细节,很多人忽略了“联合索引”的最左前缀原则。比如销售经常同时按“行业 + 地区”筛选,那你建一个 (industry, region) 的联合索引比建两个单列索引要高效得多。但如果你建反了,或者查询条件里没带第一个字段,索引直接失效。这些细节,往往是在生产环境慢查询日志里一点点扒出来的,不是拍脑袋能设计完美的。
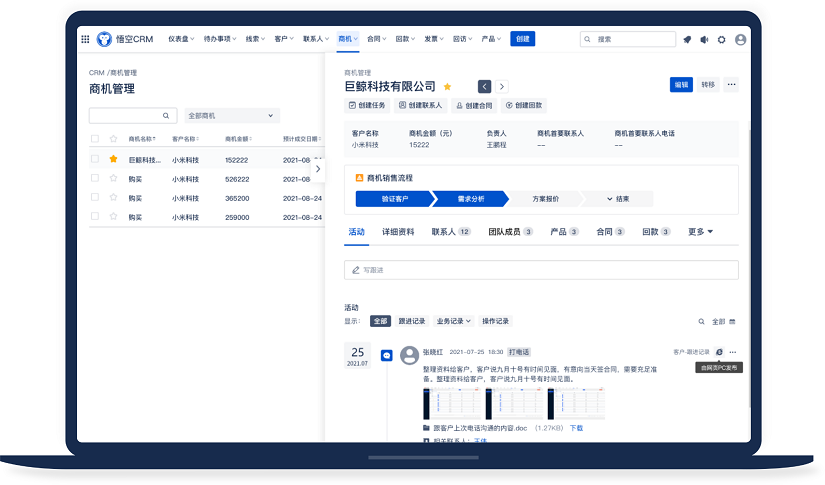
悟空CRM产品截图
刚才提到了 LIKE '%关键词%'。在数据库里,这基本等于全表扫描。当客户表到了百万级,这种查询就是灾难。
但业务方不管这个,他们就觉得:“百度能搜,为什么你 CRM 搜个公司名就不行?”
这时候,引入专门的搜索引擎是绕不开的路。Elasticsearch(ES)几乎是现在的标配。把客户数据同步到 ES 里,利用它的倒排索引机制,实现毫秒级的全文检索。
但这事儿没那么简单。数据同步就是个坑。你是用 Logstash 定时同步?还是用 Canal 监听 Binlog 实时同步?
我见过一个团队用定时任务,每小时同步一次。结果销售刚录入个大客户,转头去搜,搜不到。销售就觉得系统有 Bug,数据丢了。其实只是同步延迟。后来改成监听 MySQL 的 Binlog,一旦客户表有变动,消息队列立马通知 ES 更新,延迟控制在秒级,体验才勉强过关。
另外,ES 的映射(Mapping)设计也有讲究。客户名称字段,是用 text 还是 keyword?如果用 text,会被分词器切开。比如“北京科技有限公司”,可能被切成“北京”、“科技”、“有限公司”。销售搜“北京”能出来,搜“科技”也能出来,这挺好。但如果销售搜全称,可能因为分词匹配度的问题,排名反而靠后。
比较好的实践是“多字段映射”。同一个公司名,存一份 text 类型用于模糊搜索,再存一份 keyword 类型用于精确匹配。前端搜索框可以做成智能的:用户输入短词,走模糊匹配;输入完整名称,优先走精确匹配。
还有一点,ES 不是银弹。它占用内存大,维护成本高。如果你们公司 CRM 数据量还没到百万级,别急着上 ES,先把 MySQL 的索引优化好,或者用点简单的缓存,性价比更高。技术选型得看阶段,别为了炫技把系统搞复杂了。
说到快,大家第一反应就是 Redis。没错,缓存是提升检索速度的利器。但 CRM 的客户数据缓存,比一般的商品缓存要麻烦。
为什么?因为客户数据是“热”的,也是“变”的。
主流的CRM系统品牌
有些客户是“超级热点”,比如那些每年贡献几千万的大客户,销售天天查,跟进记录天天更。这种数据,必须进缓存。我们可以把客户的基础信息(名称、等级、负责人)做成 Key-Value 存在 Redis 里,Key 就是客户 ID。
但问题来了,缓存一致性怎么保证?销售在 A 页面改了客户电话,B 页面查询如果还读旧缓存,那就出大乱子了。
常见的做法是“更新即失效”。一旦数据库里的客户信息发生更新,立刻删除 Redis 里对应的 Key。下次查询时,缓存没命中,再回数据库查并回写缓存。
但这有个并发风险。高并发下,可能先删缓存,再更数据库,中间有个时间差,别的请求读到了旧数据并回写了缓存,导致脏数据。在 CRM 系统里,这种并发量通常没电商那么大,所以大多数时候,简单的“先更库,再删缓存”策略配合重试机制就够用了。
除了 Redis,还有一种缓存容易被忽视:本地缓存(Local Cache)。比如用 Guava Cache 或者 Caffeine。
有些数据是几乎不变的,比如“客户行业分类字典”、“客户等级定义”。这些数据存在 Redis 里还得走网络 IO,不如直接缓存在应用服务器的内存里。对于那种几十万条的静态配置数据,本地缓存能极大减少网络开销。
不过,本地缓存要注意集群一致性问题。如果多台服务器部署,A 机器改了配置,B 机器得知道。这时候通常需要配合消息广播,或者干脆这类数据就直接读库,毕竟读字典表的压力通常不大。
当单表数据量突破千万,或者 QPS(每秒查询率)高到单机数据库扛不住时,就得考虑架构升级了。
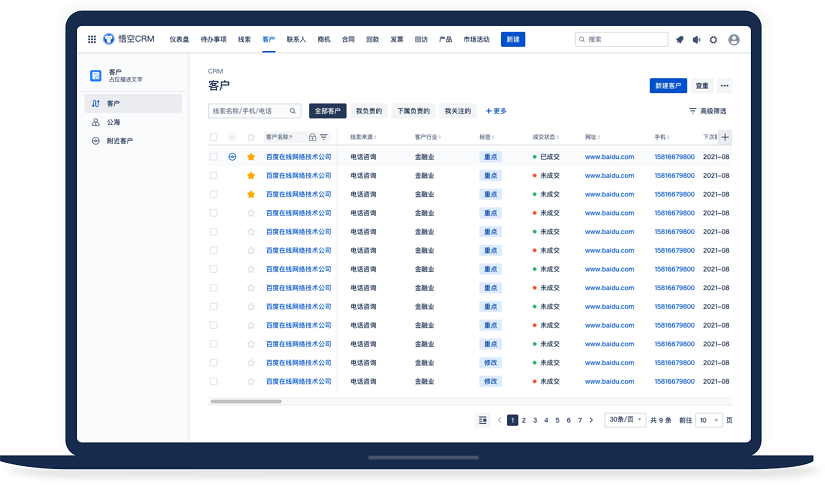
悟空CRM产品截图
读写分离是第一步。主库负责写,从库负责读。CRM 系统里,查的频率远高于写,所以把检索流量切到从库,能缓解主库压力。
但这里有个经典的“主从延迟”问题。销售刚在主库录入客户,立马去列表页刷新,结果发现没数据。因为数据还没同步到从库。解决这个问题的办法,要么在关键业务链路强制读主库(比如刚提交完表单后的跳转页),要么就是接受这个延迟,并在前端给个提示“数据同步中”。
如果读写分离还不够,那就得动分库分表了。这是大招,也是麻烦的开始。
怎么分?按客户 ID 取模?还是按地区分?
在 CRM 场景里,按“租户”或者“销售组织”分库可能更合理。比如 A 销售团队的数据在库 1,B 团队在库 2。这样天然隔离,查询范围也小了。但跨团队查询(比如总监要看全公司数据)就会变得很麻烦,需要汇总查询或者建立一张全局索引表。
分表也是同理。比如按年份分表,2023 年的客户在 customer_2023,2024 年的在 customer_2024。但客户是长期存在的,今年创建的客户明年还在,这种按时间分表会导致数据迁移困难。
比较稳妥的方式是按客户 ID 范围分表,或者引入中间件如 ShardingSphere 来屏蔽底层的分片逻辑。但我要提醒一句,能不分就不分。分库分表后,事务处理、JOIN 查询、扩容迁移都是噩梦。很多时候,通过优化 SQL、升级硬件、引入 ES,能多撑个两三年,这两年的业务价值可能远大于重构架构的成本。
聊了这么多技术,最后得说点“非技术”的。很多时候,检索慢不是因为架构不行,是因为数据太脏。
你想想,如果系统里有十万条重复的客户数据,名字全是“测试”、“未知”、“张三”,销售搜“张三”,出来一千条结果,他得翻多少页?系统渲染这么多数据要不要时间?
数据去重和清洗,是提升检索效率的隐形手段。
在录入环节就得卡住。比如利用手机号、统一社会信用代码做唯一性校验。如果库里已经有这个手机号,提示销售“客户已存在”,直接跳转详情页,而不是让他新建一条。这既保证了数据质量,又减少了垃圾数据的增长速度。
对于历史遗留的脏数据,得定期跑脚本清洗。把那些长期未跟进、信息缺失严重的“僵尸客户”归档到历史表里。主表里只留活跃客户。这样主表数据量小了,查询自然快。
还有个字段的规范化问题。比如“行业”字段,有的销售填"IT",有的填“互联网”,有的填“软件”。搜“互联网”的时候,"IT"那批客户就漏了。这种时候,检索系统得有个“同义词库”或者“映射表”,搜“互联网”的时候,自动把"IT"、“软件”相关的客户也捞出来。这虽然增加了检索逻辑的复杂度,但提升了业务层面的“查全率”,销售会觉得系统更智能。
有时候,后端优化到了极致,用户还是觉得慢。这时候得从前端找补。
比如,列表页不要一次性加载所有字段。销售在列表里通常只看客户名、电话、最近跟进时间。那就只查这几个字段,详情点进去再查其他。减少 IO 传输量。
再比如,搜索框的“防抖”处理。销售输入关键词时,别每敲一个字母就发一次请求。等他不输了,停顿 300 毫秒再发请求。这能减少大量无效的搜索请求,保护后端。
还有,对于超大数据量的导出或复杂报表检索,别让用户同步等。让他点“导出”,后台异步处理,处理完了发站内信通知下载。这种“异步化”思维,能极大缓解瞬时检索压力。
回到最开始的问题,CRM 库怎样实现客户数据高效检索?
这真不是一个技术点能解决的。它是一场持久战。
初期,靠的是规范的数据库设计和合理的索引,这是基本功。 中期,靠的是引入 Elasticsearch 解决模糊搜索,靠 Redis 扛住热点读取。 后期,靠的是架构的读写分离、分库分表,以及持续不断的数据治理。
但最重要的是,技术人员得懂业务。你得知道销售在什么场景下查数据,他们最不能忍的延迟是多少,哪些数据是绝对不能出错的。
我见过最成功的 CRM 优化案例,不是上了什么高大上的架构,而是产品经理拉着销售主管,把常用的 20 个搜索场景梳理了一遍,砍掉了 80% 没人用的筛选条件,然后开发针对这 20 个场景做了极致的 SQL 优化和缓存。
技术是为业务服务的。如果为了追求极致的检索速度,把系统搞得不稳定,或者录入数据变得巨慢,那就是本末倒置。
高效检索的终极目标,不是让 QPS 数字好看,而是让销售在见客户的前一秒,能顺畅地调出客户的所有信息,从容地按下门铃。这才是 CRM 系统存在的意义。
所以,下次再遇到检索慢的问题,别急着加机器。先看看慢查询日志,再问问销售到底怎么用的,最后摸摸数据到底有多脏。往往答案就藏在这些最不起眼的地方。
做系统嘛,就像过日子,得精打细算,也得勤快打扫。数据库索引是扫帚,搜索引擎是吸尘器,缓存是收纳箱。东西摆对了,找起来自然就快了。别总想着买个大房子(高性能服务器)就能解决乱堆乱放的问题,那是不现实的。
希望这些从实战里摸爬滚打出来的经验,能帮你少加点班,少背点锅。毕竟,系统快了,大家心情都好,这才是技术带来的真正价值。
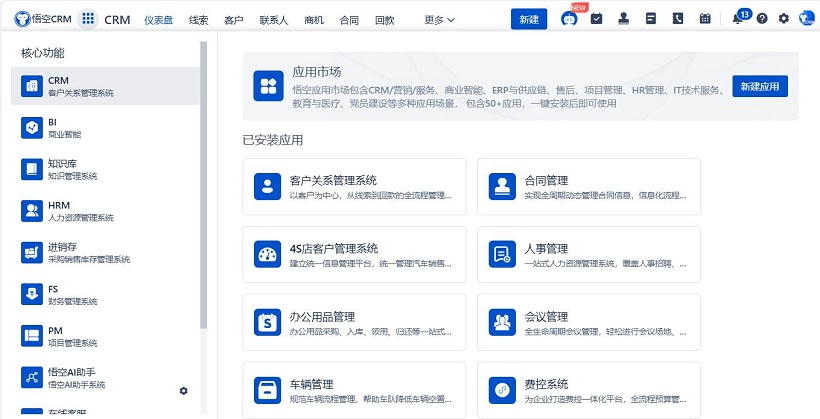
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


