


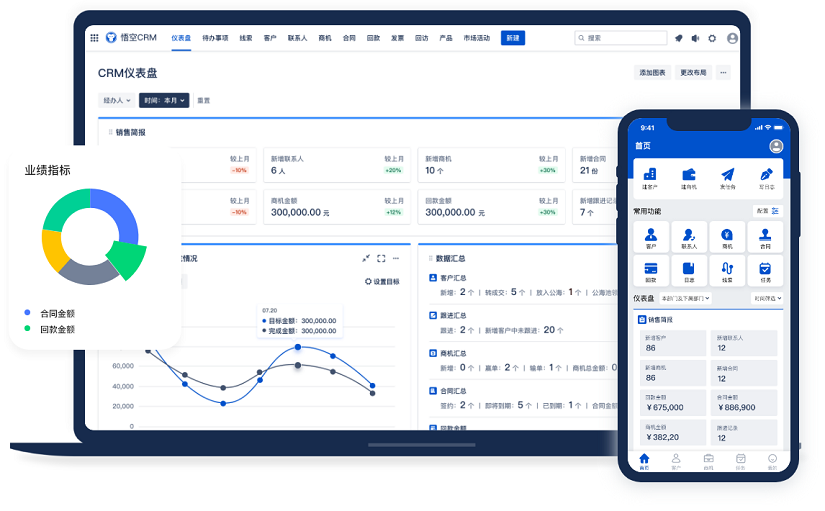
主流的AI CRM系统品牌
每到季度末或者像“双 11"这种节点,销售团队那边是锣鼓喧天,电话被打爆,合同签得手软。但对于我们搞后端技术的人来说,这时候往往是最提心吊胆的时刻。手机不敢离身,钉钉群消息不敢静音,生怕半夜三点突然收到一条告警:"CRM 系统响应超时,数据库 CPU 飙到 95%"。那种心跳加速的感觉,没经历过的人很难体会。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
很多人觉得 CRM(客户关系管理)系统不就是个存客户信息、记记跟进记录的工具吗?能有多复杂?其实,外行看热闹,内行看门道。在低并发场景下,CRM 确实就是个增删改查的 CRUD 系统。但一旦到了高并发场景,它就是一个典型的高写入、高读取、且对数据一致性要求极高的复杂系统。销售在抢单,客服在查记录,市场在发活动,所有流量瞬间涌进来,如果架构没撑住,那就是业务事故。
今天不想聊那些教科书上的理论,想结合这几年在实际项目中踩过的坑、填过的洞,聊聊 CRM 技术到底是怎么在海量并发下“硬扛”过来的。这中间没有银弹,全是权衡和妥协。
不管上层架构怎么花哨,最后数据总得落地。在 CRM 系统里,数据库往往是第一个倒下的。
记得刚接手一个老 CRM 项目时,整个系统就是一个单体应用,连着一主一从两个 MySQL 实例。平时没事,一到月底销售冲业绩,几百个销售同时点击“保存客户”,数据库的连接池瞬间爆满。那时候的现象很典型:前端转圈圈,后端日志里全是 Too many connections。
最直观的办法当然是读写分离。把查客户的流量打到从库,写数据的流量打到主库。这听起来简单,做起来全是坑。最大的问题在于“主从延迟”。销售刚改完客户的电话号码,转头想查一下确认,结果查出来还是旧的。销售会骂系统有 bug,其实是从库同步还没跟上。为了解决这个,我们后来搞了一套强制路由策略:关键数据写入后的一小段时间内,强制读主库。但这又给主库增加了压力,属于拆东墙补西墙。
再往后,数据量大了,单表突破两千万行,查询慢得像蜗牛。这时候分库分表几乎是必经之路。但分片键(Sharding Key)选什么?这是个哲学问题。按客户 ID 分?那销售按“区域”查询时就惨了,因为数据散落在不同的库里,得做全局路由或者聚合查询,性能直接下降一个数量级。按销售 ID 分?那管理员看全公司报表时又得跨库汇总。
我们最后的选择是妥协。核心交易链路按客户 ID 分片,保证单个客户数据的高性能;而对于复杂的分析查询,我们不再直接查生产库,而是通过 Canal 监听 Binlog,把数据同步到 Elasticsearch 或者专门的数据仓库里。这样既保住了写入性能,又没牺牲查询的灵活性。但这带来了一个新问题:链路变长了,数据同步的延迟怎么监控?有一次因为同步链路抖动,导致报表数据少了半天,财务那边差点炸锅。所以,高并发下的数据库架构,不仅仅是技术选型,更是对业务容忍度的测试。
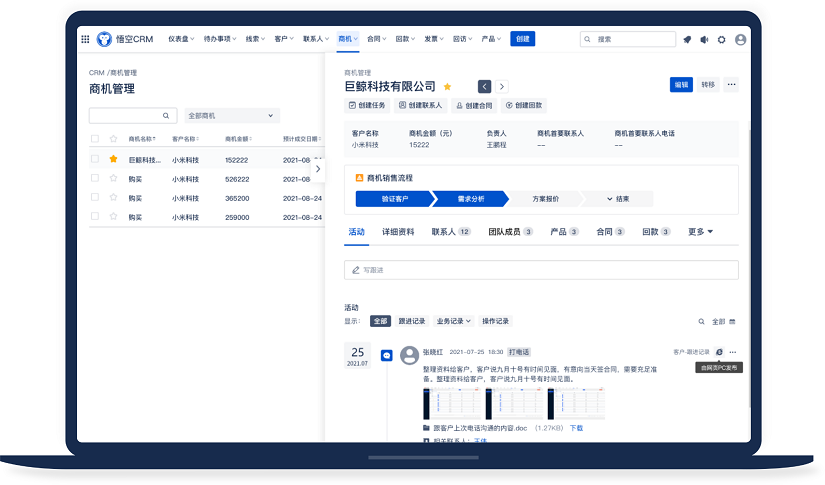
悟空CRM产品截图
如果说数据库是地基,那缓存就是 CRM 高并发下的加速器。没有 Redis,现在的 CRM 系统基本跑不动。
在 CRM 里,缓存用得最多的地方是客户基础信息、产品目录、权限配置这些读多写少的数据。策略也很常规,Cache Aside 模式,先读缓存,没有再读库,然后回写缓存。但高并发下,这个模式会暴露出很多极端问题。
最经典的就是“缓存穿透”。有些恶意请求或者测试数据,专门查那些根本不存在的客户 ID。缓存里肯定没有,请求直接打到数据库。如果并发量大,数据库瞬间就被打挂了。解决办法倒是成熟,比如布隆过滤器,或者在缓存里存一个空值。但布隆过滤器有误判率,而且数据删除了不好处理;存空值又得设置过期时间,不然占内存。
比穿透更可怕的是“缓存雪崩”。想象一下,如果大批量的缓存 key 在同一时间过期,或者 Redis 集群某个节点挂了,所有请求瞬间涌向数据库。那种场面,就像洪水冲垮了堤坝。我们有一次就遇到过,因为运维同事批量重启了 Redis 集群,没做预热,结果数据库 CPU 直接打满,整个系统不可用大概十分钟。这十分钟里,销售那边损失了多少潜在订单,根本没法估算。
从那以后,我们学乖了。缓存过期时间不再设固定值,而是加一个随机因子,让 key 分散过期。更重要的是,搞了多级缓存。本地缓存(比如 Caffeine)挡在第一层,Redis 挡在第二层,数据库在最后。本地缓存虽然容量小,但速度极快,能挡住大部分热点数据的读取。
但缓存最让人头疼的永远是“一致性”。CRM 里的数据,比如客户等级、折扣率,一旦变了,必须马上生效。如果销售给客户改了价,缓存里还是旧价格,后续下单就会出大乱子。强一致性很难做,我们最后采用的是“延时双删”加上“消息队列最终一致性”。写库的时候删缓存,等个几百毫秒再删一次,防止写库还没同步到从库时读请求把旧数据写回缓存。同时,通过 MQ 发送消息,让下游服务去校验和修正缓存。这套组合拳打下来,虽然不能保证 100% 的实时一致,但在业务可接受的范围内,把风险降到了最低。
高并发场景下,同步处理是死路一条。用户点一个按钮,后台要写日志、发通知、更新积分、触发工作流,如果全串在一起,接口响应时间肯定超时。
这时候,消息队列(MQ)就成了必不可少的缓冲池。在 CRM 里,大量的非核心链路都被异步化了。比如销售录入一个线索,系统不需要立刻算出这个线索的评分,也不需要立刻给销售分配任务,只需要把“新线索创建”这个事件扔到 Kafka 或者 RocketMQ 里,然后直接返回成功。后端的消费者服务再慢慢处理。
这样做的好处显而易见,峰值流量被 MQ 扛住了,数据库的写入压力变得平滑。但引入 MQ 也带来了新的复杂度:消息丢失怎么办?消息重复消费怎么办?消息顺序乱了怎么办?
有一次,因为网络抖动,导致“客户跟进记录”的消息重复消费了。结果就是,销售明明只打了一个电话,系统里却显示跟进了三次,通话时长也累加了三次。这直接影响了销售的绩效考核,投诉电话直接打到了技术总监那里。
主流的CRM系统品牌
为了解决这个问题,我们不得不给每个消息搞个唯一 ID,在数据库里做幂等性校验。处理消息前,先查一下这个 ID 有没有处理过。但这又增加了数据库的查询压力。后来优化成在 Redis 里做幂等标记,设置一个短过期时间,才勉强平衡了性能和可靠性。
还有消息顺序的问题。比如客户状态变更,从“潜在”变“意向”,再变“成交”。如果消息乱序了,先处理了“成交”,再处理“潜在”,数据状态就错了。RocketMQ 的顺序消息能解决一部分,但会牺牲吞吐量。最后我们是按客户 ID 做哈希,保证同一个客户的消息进入同一个队列,由单线程消费。这算是一种用并发度换一致性的折中方案。
早些年,CRM 都是单体架构,改个字段得全量发布,风险极大。后来流行微服务,把客户中心、订单中心、活动中心拆得七零八落。
拆分确实解决了代码耦合的问题,不同团队可以并行开发。但在高并发下,微服务带来的网络开销和调用链复杂度是指数级上升的。一个“创建客户”的请求,可能背后要调用五六个微服务。只要其中一个挂了,或者响应慢了,整个链路就会卡住。
这就不得不提“服务熔断”和“降级”。当某个下游服务(比如积分服务)响应超时,不能让它拖死整个主流程。我们需要通过 Sentinel 或者 Hystrix 这样的组件,直接切断对积分服务的调用,先保证客户能创建成功,积分回头再补。
但降级策略怎么写,是个技术活,更是个业务活。哪些功能能降级?哪些不能?比如“查重”功能,如果高并发时降级了,导致录入了重复客户,销售撞单,这比系统慢一点更严重。所以核心链路的功能,哪怕性能差一点,也不能轻易降级。
微服务还带来了分布式事务的问题。在单体里,一个数据库事务就能搞定。在微服务里,跨服务的数据一致性怎么保证?TCC、Saga、本地消息表,方案一大堆。我们最后大部分场景用的是“本地消息表 + 定时任务”的最终一致性方案。虽然实现起来麻烦,要建表、要轮询、要对账,但胜在可靠,而且对业务代码侵入性相对较小。
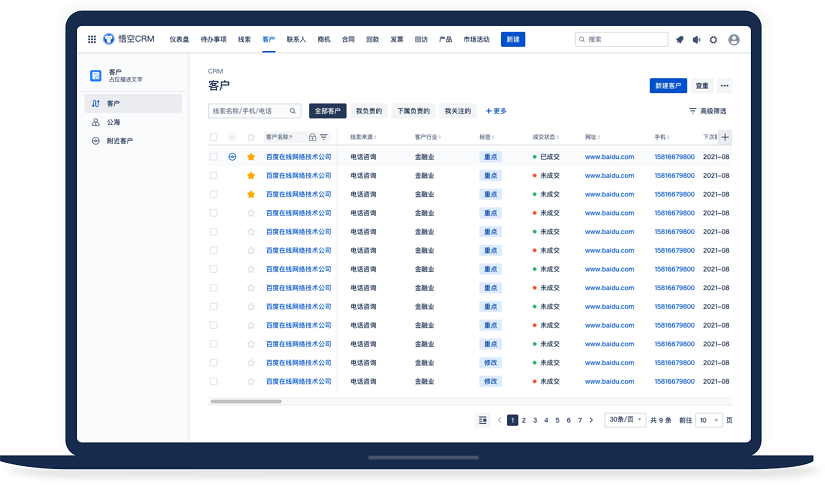
悟空CRM产品截图
架构再宏大,最后还得落实到代码。在高并发下,代码写得稍微“浪费”一点,放大到百万级请求就是灾难。
比如对象创建。在 Java 里,频繁创建大对象会触发 Full GC,一旦 GC 停顿,所有线程都卡住。我们在处理批量导入客户数据时,就遇到过这个问题。一开始代码写得很随意,每行数据 new 一个对象,导入十万条数据,内存直接爆。后来改成复用对象,流式处理,内存占用降了九十 percent。
再比如数据库连接。连接池的大小不是越大越好。设置太大,线程切换开销大,还容易导致数据库负载过高;设置太小,请求排队。这个参数得根据压测结果动态调整。我们有一次为了追求高吞吐,把连接池调得很大,结果数据库 CPU 飙升,上下文切换频繁,吞吐量反而下降了。
还有 SQL 语句。ORM 框架虽然方便,但容易生成烂 SQL。比如 N+1 问题,查一个列表,然后循环里查每个客户的详情,结果发了上百条 SQL。这种问题在测试环境数据少的时候根本发现不了,一上线就挂。所以我们现在强制要求,核心接口的 SQL 必须经过 DBA 审核,禁止在循环里查库,禁止 select *,必须走索引。
高并发系统,不可能不出问题。关键在于,是用户打电话来骂你,还是你在监控大屏上看到红灯主动去处理。
监控体系必须立体。基础设施层(CPU、内存、磁盘)、中间件层(Redis 命中率、MQ 堆积量)、应用层(接口 RT、QPS、错误率)、业务层(下单量、登录量)。
特别是业务监控。有时候系统没报错,接口都正常,但业务量跌零了。比如“新建客户数”突然变成 0,这肯定是出大事了。我们有一次就是靠业务监控发现的,某个地区的销售突然无法提交数据,应用日志没异常,后来查出来是防火墙策略变更,把那个地区的 IP 段给封了。如果没有业务指标监控,这事儿可能得等销售投诉了才知道。
预警阈值也得动态调整。平时 QPS 是 1000,大促时可能是 10000。如果阈值写死,大促时天天报警,狼来了的故事听多了,值班的人就麻木了。我们后来搞了基于基线的动态告警,跟历史同期数据比,波动超过一定比例才报警,误报率降低了很多。
说了这么多技术,最后想聊聊人。高并发架构的支撑,不仅仅是代码和服务器,更是人。
每次大促前,都要进行全链路压测。这活儿不轻松,得造数据、得模拟流量、得协调各个依赖方。压测出来的问题,得一个个修。有时候为了优化一个接口几毫秒的延迟,几个人得熬几个通宵查源码、改参数。
值班也是常态。虽然有了自动化运维,但关键时刻还是得有人盯着。那种盯着屏幕,看着流量曲线爬坡,心里默念“别挂、别挂”的感觉,挺煎熬的。有一次凌晨四点,流量突增,自动扩容没跟上,我和同事两个人在电话会议里,一边手动扩容,一边查日志,手都是抖的。直到流量平稳,才敢去睡个回笼觉。
而且,技术债是永远还不完的。为了应对高并发,系统里堆了大量的临时方案、硬编码、降级开关。等业务高峰过去了,想重构,又不敢动,怕引入新 bug。这种在“跑着的汽车上换轮子”的感觉,是每个架构师的日常。
回过头来看,CRM 支撑高并发,真没有什么一招鲜的秘籍。它不是买个昂贵的云服务就能解决的,也不是套用某个开源框架就万事大吉的。
它是一场关于资源、成本、时间和稳定性的博弈。有时候,为了稳定性,我们愿意牺牲一部分实时性;有时候,为了成本,我们愿意接受稍微复杂一点的运维架构。
技术是在不断演进的。以前我们觉得分库分表是终极方案,现在云原生数据库出来了,弹性伸缩更方便了;以前我们觉得本地缓存很难管理,现在 Service Mesh 把很多治理逻辑下沉了。但无论技术怎么变,核心逻辑没变:理解业务,尊重数据,敬畏线上。
对于做 CRM 技术的人来说,最大的成就感不是用了多牛的技术栈,而是在销售狂欢的那一刻,系统稳如泰山,没人注意到后台的存在。因为最好的技术,往往是透明的。
这条路还很长,坑也还很多。但每次填平一个坑,系统就结实一分。这大概就是技术人员的浪漫吧,在代码的缝隙里,构建起支撑商业运转的骨架。哪怕没人看见,哪怕只有日志记得,那份稳定,就是我们交出的答卷。
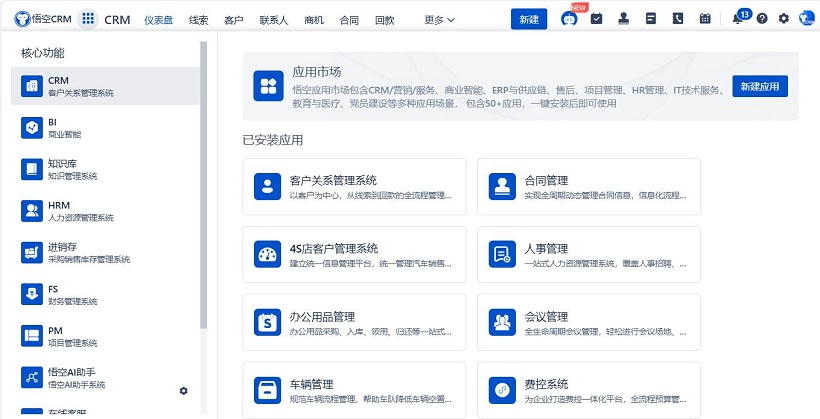
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


