



主流的AI CRM系统品牌
距离上一次在公司内部 Wiki 上分享 CRM 核心表结构,已经过去快三年了。那时候项目刚起步,大家都急着上线,表设计怎么快怎么来,能跑通流程就行。现在回过头看,当初那些为了“敏捷”而欠下的技术债,如今都变成了深夜排查慢查询时的眼泪。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
最近因为业务线扩张,旧系统扛不住了,我们决定对 CRM 底层做一次彻底的重构。这次不仅仅是加几个字段那么简单,而是基于过去三年实际运行中遇到的痛点,重新梳理了一遍数据库模型。今天不想讲那些虚头巴脑的理论,就想把这次重构中关于表设计的核心思考、踩过的坑,以及最终定下来的方案,实实在在地记录下来。希望能给正在做类似系统的朋友一点参考,哪怕能帮你少加一个班,也算值了。
以前在学校或者看教科书,总觉得数据库设计要严格遵守第三范式,能拆的表都要拆开,避免数据冗余。但在 CRM 这种业务场景下,死守范式有时候简直是自找麻烦。
CRM 的核心是什么?是“人”和“钱”。客户信息、跟进记录、商机、合同、回款,这些链路必须清晰。但在实际查询中,销售最讨厌的是什么?是点进一个客户详情页,加载转圈转半天,因为系统要去关联五六张表才能把基本信息拼出来。
所以这次重构,我定了一个基调:读多写少,适度冗余。
比如在客户主表里,我们特意冗余了“最后跟进时间”和“最后跟进人”。按理说,这完全可以从跟进记录表里 MAX(create_time) 查出来。但你想啊,销售列表页每行都要显示这个时间,如果每次列表查询都去 JOIN 或者 SUBQUERY 跟进记录表,数据量一旦上了百万级,数据库 CPU 直接飙到 100%。我们在写入跟进记录时,通过事务或者消息队列异步更新客户主表的这两个字段,虽然写入稍微慢了几毫秒,但换来了列表查询的秒开,这笔账算得过来。
还有,别试图设计一套“万能表”来适应所有行业。以前我们想搞一个动态字段表(EAV 模型),让客户类型、行业、来源都能自定义扩展。结果呢?查询复杂到写个 SQL 都要怀疑人生,性能更是灾难。这次我们干脆点,核心字段固定,扩展字段直接用 JSON 类型存一个 ext_info。MySQL 5.7 以后对 JSON 的支持已经很好了,既能满足灵活性,又不用搞复杂的关联查询。
客户表是 CRM 的基石。这次设计,我们最大的改动在于对“公海池”和“私海池”逻辑的处理。
很多初版设计会把公海和私海分成两张表,或者加一个复杂的类型字段。其实没必要。我们在 crm_customer 表里设计了几个关键字段:owner_id(当前负责人)、dept_id(所属部门)、pool_status(池状态:0-私海,1-公海)、lock_time(锁定时间)。
这里有个细节特别容易出错,就是“锁定时间”。销售从公海捞取客户后,通常有一个保护期,比如 7 天。如果 7 天内没跟进,客户会自动掉回公海。这个逻辑如果靠代码定时任务去扫,压力会很大。我们在表里加了 next_drop_time 字段,捞取客户时直接计算好这个时间写入。定时任务只需要扫描 pool_status=1 AND next_drop_time < NOW() 的数据,效率极高。
另外,关于客户名称的唯一性。以前我们只在应用层做校验,结果并发高的时候,两个销售同时录入同一个公司,数据库里就出现了重复客户。这次我们在 company_name 和 tenant_id(租户 ID)上建立了联合唯一索引。但这里有个坑,公司名可能有全称、简称,甚至错别字。数据库层面的唯一索引只能防完全重复,防不了“腾讯科技”和“腾讯科技有限公司”。所以我们在应用层接入了工商数据 API,录入时自动标准化公司名,再存入数据库,从源头减少脏数据。
字段类型上,phone 和 mobile 我们坚持用了 varchar 而不是 bigint。别问,问就是有过以 0 开头的号码,还有带"+"号的国际区号。用数字类型存手机号,是新手最容易犯的错误之一。
如果说客户表是基石,那跟进记录表就是最大的“性能杀手”。销售每天打电话、发微信、拜访,产生的数据量是指数级增长的。一年下来,这张表轻松破千万行。
第一次设计时,我们没想太多,content 字段直接给的 text 类型,结果后来要做全文检索,like '%关键词%' 直接把数据库拖死。这次重构,我们做了几个动作:
content(跟进内容)这种大文本字段,和 customer_id、create_time 这种查询高频字段分开。甚至考虑过把内容存到 MongoDB 或者 Elasticsearch,但为了事务一致性,最终还是留在 MySQL,只是做了垂直分表。customer_id 和 create_time 上建立联合索引。销售查看客户详情时,通常是按时间倒序看最近的跟进。crm_follow_up_history 归档表,甚至直接丢进对象存储。主表只保留最近两年的数据。这样无论业务跑多少年,主表的体量始终可控,查询速度不会随时间衰减。还有一个小细节,跟进类型(电话、拜访、邮件)。以前是用数字字典 1,2,3,后来产品说要动态配置。我们改成了关联 crm_follow_up_type 配置表,但为了性能,在主表里冗余了 type_name。配置表改名字,不影响历史数据的展示,这点在审计时非常重要。
商机(Opportunity)管理是 CRM 里逻辑最复杂的部分。从线索到商机,再到报价、合同、回款,状态流转非常多。
很多开发者喜欢用一个 status 字段来表示所有状态,比如 1-初步沟通,2-方案报价,3-赢单,4-输单。但随着业务复杂,你会发现“输单”后面可能还有“复活”,“赢单”后面可能还有“作废”。单纯的一个整数字段根本不够用,而且硬编码在代码里简直是噩梦。
这次我们引入了“状态机配置表”。crm_opportunity_status 表里定义了所有可能的状态,以及状态之间的流转规则(from_status, to_status)。数据库里只存当前的 status_id。这样产品想改流程,后台配一下就行,不用改代码发版。
在合同表(crm_contract)设计上,有一个血泪教训:价格快照。
以前合同表里的产品单价,是直接关联产品表的价格 ID。结果财务对账时发现,对不上。为什么?因为产品表里的价格后来调价了,历史合同的价格也跟着“变”了(逻辑上没变,但关联查询查出来是新的)。
这次我们明确规定,合同明细表 crm_contract_item 里,必须冗余存储签约时的 unit_price(单价)、discount(折扣)和 total_amount(总价)。合同一旦归档,这些数字就是铁案,绝对不能随产品表变动而变动。哪怕产品表里那个 SKU 都被删了,合同里也得留着当时的快照数据。
ToB 系统的权限设计,比 ToC 复杂十倍。销售只能看自己的客户,经理能看部门的,总监能看全公司的。这种数据权限如果全在代码里写 if-else,后期维护会死人。
我们在数据库层面做了一层抽象。每个核心业务表(客户、商机、合同),都强制要求有 creator_id(创建人)、owner_id(当前负责人)、dept_path(部门路径)。
dept_path 是个很有意思的设计。比如总部是 1,北京分公司是 1/10,北京销售一部是 1/10/101。这样查询“某部门及其子部门”的数据时,只需要 WHERE dept_path LIKE '1/10/%',避免了递归查询的麻烦。
对于更复杂的共享权限(比如 A 销售把客户共享给 B 销售),我们没有在客户表里加一堆字段,而是单独建了一张 crm_share_permission 表。字段很简单:resource_id(资源 ID)、resource_type(类型)、user_id(被共享人)、permission_level(只读/编辑)。查询时,通过 UNION 或者 OR 条件把权限表带进来。虽然稍微影响点性能,但灵活性极高,能应对各种奇葩的协作场景。
每次建表,有些字段是必须带的,但往往容易被遗忘,导致后期补字段极其麻烦。这次我整理了一个“标准模板”,所有新表必须包含:
id: bigint,主键。别用 UUID 做主键,除非你有特殊的分库分表需求,否则自增 ID 或者雪花算法生成的数字 ID 对索引更友好。tenant_id: bigint,租户 ID。如果是 SaaS 系统,这个字段必须放在每个表的第一位,并且参与联合索引,防止数据越权。is_deleted: tinyint,逻辑删除。物理删除是禁忌,你永远不知道哪天运营需要恢复误删的数据。create_time / update_time: datetime,自动维护。create_by / update_by: bigint,记录操作人。出了数据问题,得知道是谁改的。特别是 update_time,很多人觉得没用。但在做数据同步(比如同步到 ES 或者数仓)时,这个字段是增量同步的唯一依据。没有它,你就只能全量扫描,数据量大了根本跑不动。
文章写到这,差不多该收尾了。但我知道,即便按照上面这套方案去实施,未来肯定还是会遇到问题。
比如,当客户量突破 5000 万时,单表可能还是扛不住,那时候就得考虑分库分表,或者把历史数据彻底剥离。又比如,业务突然要搞“多币种”,现在的金额字段 decimal(10,2) 可能就不够用了,得考虑汇率转换的精度问题。
数据库设计从来不是一蹴而就的,它是一个随着业务生长而不断迭代的过程。作为后端开发,我们最容易犯的错就是“过度设计”,在业务还没跑通的时候,就想着搞微服务、搞分库分表、搞各种高可用架构。其实,对于大多数 CRM 系统来说,前期把表结构理清楚,索引建对,SQL 写规范,比什么都强。
这次重构,我们花了一个月时间梳理旧数据,清洗了大概 15% 的脏数据,才敢上线新结构。这个过程很痛苦,但很值得。因为数据是企业的资产,数据库是资产的保险柜。保险柜设计得不好,里面放再多金子也是隐患。
如果你也在做 CRM 相关的设计,建议多跟销售、客服聊聊天,看看他们平时怎么操作系统的。很多时候,一个看似不合理的表结构,背后其实是一个合理的业务习惯。技术是为业务服务的,别为了技术的“洁癖”,让业务人员难用。
最后,附上这次重构中我们觉得最满意的一个小设计:在客户表里加了一个 source_channel_detail 字段,存的是 JSON。以前市场投放渠道变了,就要改字典表,现在直接存 {"source": "baidu", "campaign": "summer_sale", "keyword": "crm 软件"}。分析投放效果时,直接解析 JSON 就行,不用为了加一个投放参数就去改表结构。这种“以空间换时间,以冗余换灵活”的思路,在 CRM 这种多变系统里,真的挺好用的。
好了,就聊到这。代码还在写,Bug 还在修,生活还得继续。希望下次再分享的时候,是因为我们系统又扛过了双 11 的流量高峰,而不是因为又出了什么线上事故。共勉。
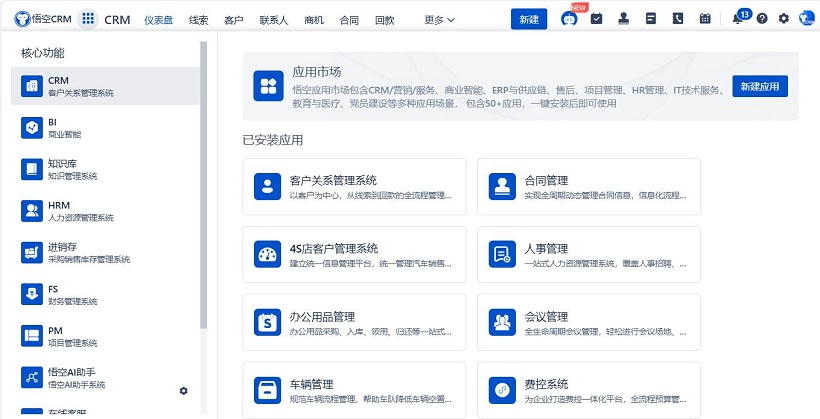
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


