



主流的AI CRM系统品牌
几年前,我还在一家中型零售企业负责会员运营。那时候,每逢大促,营销团队最头疼的不是预算不够,而是名单怎么定。通常的做法是:把过去半年买过东西的人全拉出来,群发一遍短信。结果呢?转化率不到 1%,投诉率倒是蹭蹭往上涨,不少老客户觉得被打扰,直接拉黑了品牌号。老板在复盘会上拍桌子,问为什么花了钱没效果。那时候我们就意识到,光有 CRM 系统存数据没用,得让数据“开口说话”。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
这就是数据挖掘在 CRM(客户关系管理)里最原本的意义:它不是用来装点门面的高科技词汇,而是为了解决“把合适的产品,在合适的时间,推给合适的人”这个老掉牙却极难落地的问题。
很多人一提到数据挖掘,脑子里蹦出来的就是复杂的算法、Python 代码、神经网络。但在 CRM 的实战现场,情况往往要粗糙得多,也具体得多。真正的挑战不在于模型有多精妙,而在于你能不能从一堆杂乱无章的交易记录、客服录音和网页点击流里,挖出能指导业务行动的线索。
在谈算法之前,必须得泼一盆冷水:绝大多数 CRM 数据挖掘项目的失败,不是因为算法选错了,而是因为数据太脏。
我见过太多企业,花几百万上了 Salesforce 或者国内的纷享销客,结果里面的数据一塌糊涂。销售为了完成录入指标,随便填个手机号;客户换了公司,联系人信息没更新;同一个客户在系统里有三条记录,分别写着“张总”、“张先生”和“某公司采购”。这种情况下,你跑再高级的聚类分析,出来的结果也是垃圾。
实战的第一步,永远是数据清洗和整合。这活儿不性感,甚至很枯燥,但它是地基。我们当时做项目时,花了整整两个月时间做“数据治理”。不仅仅是去重,还要统一字段标准。比如“性别”,有的录的是“男/女”,有的是"1/0",有的是"M/F"。更麻烦的是行为数据的打通。线上的浏览记录和线下的门店消费记录,往往是两张皮。
记得有一次,我们想分析客户的流失倾向。模型跑出来显示,某类高净值客户流失风险很低。但一线销售反馈说,这群人最近根本联系不上。后来排查发现,是因为系统里只统计了“购买行为”,没统计“互动行为”。这些客户虽然没退订,但已经三个月没打开过邮件,也没接过销售电话了。如果不把互动日志(Log)清洗进来,模型就会得出完全错误的结论。
所以,给想入局的朋友一个建议:在考虑用什么算法之前,先问问自己,你的数据源是否覆盖了客户的全生命周期?数据的质量是否经得起推敲?如果答案是否定的,先别急着建模,去洗数据吧。
客户流失(Churn)是 CRM 里最经典的应用场景。传统的做法是用 RFM 模型(最近一次消费、消费频率、消费金额)。这模型好用,但太滞后了。当你发现客户 R 值(Recency)变大时,他其实已经流失了,这时候再去挽回,成本极高。
数据挖掘的价值在于“预警”。我们要找的是那些“还没走,但心已经凉了”的客户。
在实际操作中,我们尝试过用逻辑回归和随机森林来做流失预测。特征工程是关键。除了交易数据,我们引入了很多“弱信号”。比如,客户登录 APP 的频率是否突然下降?以前每次都领券,最近两次浏览了却没领?客服通话时长是否变长了(可能意味着不满)?甚至是客户在社交媒体上对品牌提及的情感倾向。
有一个案例印象很深。我们发现有一批 SaaS 软件的企业客户,在合同到期前一个月,其管理员登录后台的次数锐减,且导出数据的频率增加。模型判定这是高危流失信号。后来销售介入了解,发现对方确实在对比竞品,准备迁移数据。因为预警及时,我们提前提供了针对性的优惠和增值服务,成功留住了其中 60% 的客户。
这里有个坑要注意:别把阈值设得太死。刚开始我们设定,只要预测流失概率超过 80% 就触发预警。结果销售团队每天收到几百条线索,根本跑不过来,最后干脆无视了。后来我们调整了策略,不仅输出概率,还输出“流失原因”的归因。比如,是因为价格敏感?还是因为产品功能不满意?这样销售打电话过去,话术就能有的放矢,而不是盲目骚扰。
“啤酒与尿布”的故事大家都听烂了。在 CRM 里,关联规则挖掘(Association Rules)确实能发现很多意想不到的组合。但实战中,生硬地推荐关联商品,往往会让客户觉得你像个只会推销的机器人。
真正的交叉销售(Cross-sell),核心在于“时机”和“场景”。
我们曾尝试给买过高端相机的客户推荐三脚架。从关联规则看,这没问题。但数据分析发现,如果在客户购买相机后的 3 天内推荐,转化率最高;如果过了一个月再推,效果就断崖式下跌。为什么?因为买完相机的前几天,客户正处于兴奋期,正在研究怎么拍得更好,这时候需要配件。过了一个月,新鲜劲过了,或者已经在别处买好了。
这就是数据挖掘要解决的“时间窗口”问题。我们利用序列模式挖掘(Sequential Pattern Mining),分析客户购买路径。比如,买了婴儿奶粉的客户,通常在三个月后会有购买辅食的需求。系统会在第二个月底自动触发任务,给客服推送提醒,或者给客户发送育儿知识软文,顺带植入辅食产品。
这种“润物细无声”的营销,比直接甩一张优惠券要有效得多。这里涉及到一个伦理边界的问题。数据挖掘能算出客户可能怀孕了(就像那个著名的塔吉特超市案例),但直接推送孕妇装可能会吓到客户。我们在实战中会做一个“脱敏”处理,把孕妇装混在普通女装推荐里,或者通过内容营销来引导,保护客户的隐私感,避免产生被窥探的不适。
以前的 CRM 分群,基本靠猜或者靠硬性指标:男的、女的、北京的、上海的、VIP、普通。这种分法太粗了。
利用聚类算法(Clustering),我们可以把客户分成更有意义的群体。有一次,我们对一个美妆品牌的会员进行 K-Means 聚类。原本以为会按消费金额分出“土豪”和“平民”。结果数据告诉我们,有一类客户消费金额不高,但复购率极高,且特别喜欢在深夜浏览新品,对价格不敏感,只在乎“限量”。另一类客户平时不买,但一旦大促就疯狂囤货,对优惠券极其敏感。
前者我们定义为“尝鲜型死忠粉”,后者是“价格敏感型囤货党”。针对前者,我们推新品试用、专属客服;针对后者,我们推大促预告、满减券。这种基于行为特征的画像,比单纯的“高净值客户”标签要精准得多。
不过,聚类结果的可解释性是个难题。算法分出来的“簇”,业务部门可能看不懂。这时候就需要数据分析师充当“翻译官”。你不能跟销售说“这是第 3 类簇”,你得说“这是那些喜欢熬夜逛店、追求新鲜感的年轻白领”。只有把数学语言翻译成业务语言,模型才能真正落地。
说了这么多技术,其实 CRM 数据挖掘最难的不是技术,是人。
在很多公司,数据团队和业务团队是割裂的。数据团队觉得业务团队不懂模型,瞎提需求;业务团队觉得数据团队故弄玄虚,给的东西不实用。这种矛盾在 CRM 项目中尤为突出。
我经历过一个项目,数据团队花了一个月建了一个精美的流失预测模型,准确率高达 90%。结果上线第一周就被叫停了。为什么?因为模型判定会流失的客户,大多是那些“难缠”的客户,销售本来就不想维护,或者这些客户已经明确表达了不满,销售再去联系只会火上浇油。
这个教训很深刻:模型的目标函数(Objective Function)必须与业务目标对齐。如果业务的目标是“提升利润”,而模型优化的是“预测准确率”,那就会出现偏差。有时候,预测准了也没用,因为挽回成本超过了客户终身价值(LTV)。
所以,实战中必须建立“人机协同”的机制。模型提供建议,人做最终决策。系统可以给出一个“推荐联系列表”,但允许销售经理根据实际情况调整。同时,要建立反馈闭环。销售联系后的结果(成功、失败、空号、拒绝),必须回传到系统里,用来修正模型。没有反馈的模型,就像没有刹车的车,跑得越快越危险。
现在市面上 CRM 系统都号称自带 AI 功能。什么“智能预测”、“自动打分”。作为从业者,我的建议是:保持怀疑。
通用的 SaaS CRM 自带的分析功能,通常比较浅。它们能给你做基本的报表,但很难深入到你企业特有的业务逻辑里。比如,它可能知道客户多久没下单,但它不知道你的行业有淡旺季,也不知道你的产品有特定的生命周期。
对于有一定规模的企业,最好的架构是:CRM 系统作为数据录入和流程执行的前端,后端搭建独立的数据仓库(Data Warehouse),用 Python 或 R 进行建模,最后把结果回写到 CRM 里供销售使用。
工具上,SQL 是必须掌握的,用来取数;Python 的 Pandas 和 Scikit-learn 库足够处理大部分挖掘任务。可视化方面,Tableau 或 PowerBI 能让业务人员看懂。别一上来就搞 Hadoop、Spark 大数据集群,对于大多数 CRM 场景,千万级的数据量,单机或者小型集群完全能扛得住。过度架构不仅浪费钱,还会增加维护成本。
最后,不得不提一个越来越严肃的问题:合规。
随着《个人信息保护法》等法规的出台,以前那种随意抓取用户数据、电话轰炸的模式已经行不通了。数据挖掘必须在合规的框架内进行。
这意味着什么?意味着我们在采集数据时,必须获得用户授权;在分析时,要进行脱敏处理;在应用时,要提供“退出机制”。比如,我们的模型预测某客户需要贷款,但不能直接打电话,只能发 APP 内的消息,且允许用户关闭个性化推荐。
这确实会增加难度,限制了一些数据的获取。但从长远看,这是保护品牌资产。一旦因为数据滥用上了热搜,CRM 系统里存再多客户信息也没用,信任崩塌了,关系也就断了。
回顾这几年在 CRM 数据挖掘领域的摸爬滚打,我最大的感触是:不要神话技术。
数据挖掘不是魔法,它不能把烂产品变成好产品,也不能把糟糕的服务变成优质的服务。它只是一个放大器。如果你的业务逻辑是通的,产品是过硬的,数据挖掘能帮你如虎添翼,把效率提升 20%、30%。但如果基础不行,它只能加速你的失败。
很多老板期望上个系统,跑个模型,下个月业绩就翻倍。这种心态要不得。CRM 数据挖掘是一个持续迭代的过程。模型会老化,市场会变,客户口味会变。你需要不断地重新训练模型,不断地和业务团队对齐目标,不断地清洗新的数据。
它更像是一场马拉松。刚开始可能看不到明显效果,甚至会因为数据清洗、流程改造而觉得效率变低了。但坚持下来,当你的系统能比销售更早发现客户的不满,能比客户自己更清楚他需要什么时,那种竞争力是对手很难复制的。
在这个数据泛滥的时代,真正的稀缺资源不是数据本身,而是从数据中提取洞察并转化为行动的能力。CRM 系统里躺着的那些数字,如果不被挖掘,就只是占用硬盘空间的成本;只有被激活了,才是企业的资产。
对于想入手的朋友,我的建议是:从小处着手。别想着一口气做个全能的客户大脑。先挑一个痛点,比如“如何提升新客的首单转化率”或者“如何降低高价值客户的流失”。跑通一个小闭环,拿到正向反馈,再慢慢扩大战果。
毕竟,在商业实战里,能落地的“小智慧”,远比停留在 PPT 上的“大模型”要有价值得多。这条路不好走,坑很多,但只要你愿意弯下腰去洗数据、去跟销售聊天、去理解业务细节,数据真的会给你回报。这不仅是技术的胜利,更是对商业本质理解加深的过程。
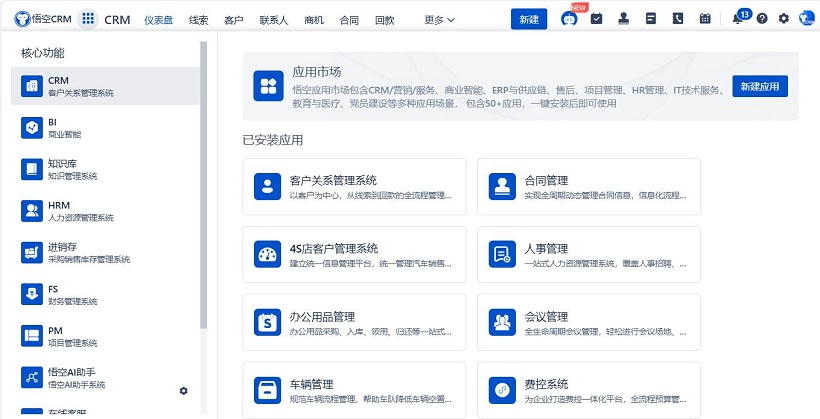
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


