



主流的AI CRM系统品牌
干后端这么多年,接手过最烂的摊子,往往不是高并发秒杀系统,而是看似简单的 CRM(客户关系管理)。为什么?因为秒杀系统的难点在架构,边界清晰;而 CRM 的难点在业务,边界模糊,且随着销售策略的变化,数据结构恨不得每个月都要改。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
很多刚入行的开发,或者外包团队,拿到 CRM 需求,第一反应就是建三张表:客户表、联系人表、订单表。觉得这就够了?等你上线半年,销售总监拿着报表拍桌子问“为什么这个季度的转化率算不对”,或者“为什么我查个客户手机号要卡三秒”的时候,你就知道当初设计有多草率了。
今天不聊虚的架构理论,就聊聊我在实际项目中,用头发换来的 CRM 数据库表结构设计经验。咱们从核心实体、扩展性、性能陷阱以及那些容易被忽视的细节,一点点拆开说。
这是 B2B 和 B2C 业务最容易混淆的地方。在 B2C 里,Customer 就是 User,是一个人。但在 B2B 场景下,你必须把“客户(Account)”和“联系人(Contact)”彻底分开。
我见过最坑的设计,是把公司信息和联系人信息混在一张表里。结果呢?一个公司有五十个联系人,数据冗余五十次。一旦公司电话变了,你得更新五十条记录,漏一条就是数据不一致。
正确的做法是:
crm_account 表存企业主体信息。字段别只存个名字,至少要包含:
unified_social_credit_code(统一社会信用代码):这是去重的关键索引。很多销售为了业绩会重复录入客户,有了这个码,系统能自动合并。industry_level_1/2/3:行业分类,别用字符串,用关联字典表的 ID,方便后续做 BI 分析。ownership_type:企业性质(国企、外企、民营),这对销售策略很重要。risk_level:风控等级,这个字段后期会被财务系统频繁调用。crm_contact 表存具体的人。这里有个细节,account_id 是外键,但一定要允许为空。为什么?因为有些线索阶段,你还不知道他属于哪家公司,或者他是自由职业者。如果设为 NOT NULL,录入流程就会卡住。
另外,联系人表里一定要加 is_decision_maker(是否决策人)和 influence_level(影响力等级)。这看起来是业务字段,但直接决定了销售跟进的优先级。数据库设计不仅仅是存数据,更是固化业务流程。
CRM 的核心是销售漏斗(Pipeline)。从线索(Lead)到商机(Opportunity),再到成交(Deal)。很多设计喜欢用一张大表,加一个 type 字段来区分。
千万别这么干。
线索和商机的生命周期完全不同。线索可能是个冷数据,量大,字段少;商机是热数据,涉及金额、预计成交时间、竞争对手,字段多且复杂。混在一起,查询效率极低,且索引难以优化。
建议拆分为 crm_lead 和 crm_opportunity。
在 crm_opportunity 表里,最头疼的是阶段管理。销售流程可能是:初步接洽 -> 需求分析 -> 方案报价 -> 谈判 -> 赢单。
新手喜欢用 status 字段存中文,或者用 1, 2, 3 存数字。
老手会怎么做?
会单独设计一张 crm_pipeline_stage 表,关联商机表。因为不同产品线,销售流程不一样。卖软件可能是 5 个阶段,卖硬件可能是 8 个阶段。如果把阶段写死在商机表里,后期改流程就是改表结构,这是大忌。
还有一个容易被忽视的字段:next_followup_time(下次跟进时间)。
销售每天打开 CRM,最需要看到的是“今天该联系谁”。这个字段必须加索引。而且,最好有个触发器或者定时任务,当商机状态变更时,自动清空或更新这个时间,防止销售忘了填,导致数据脏乱。
CRM 最难搞的是“自定义字段”。A 客户需要记录“员工人数”,B 客户需要记录“厂房面积”。 五年前,主流方案是 EAV(Entity-Attribute-Value),即搞三张表:主表、属性定义表、属性值表。 我现在坚决反对在核心交易链路用 EAV。 查询太痛苦了。你想查“员工人数大于 100 且行业是互联网的客户”,得 join 三次表,数据量一上来,CPU 直接飙满。
现在 MySQL 5.7+ 或者 PostgreSQL 对 JSON 支持很好。
我的建议是:在 crm_account 和 crm_opportunity 表里,直接加一个 ext_attributes 字段,类型 JSON。
把不常用的、动态的自定义字段扔进去。
比如:
{
  "employee_count": 150,
  "factory_area": 2000,
  "custom_tag_1": "vip"
}
查询时,利用 MySQL 的 JSON_EXTRACT 或者 PG 的 JSONB 操作符,性能完全够用。
SELECT * FROM crm_account WHERE JSON_EXTRACT(ext_attributes, '$.employee_count') > 100;
这样既保证了核心表的整洁,又满足了 SaaS 场景下多租户的个性化需求。
当然,如果某个自定义字段被高频用于筛选(比如“客户等级”),那就别偷懒,把它从 JSON 里提出来,变成物理字段,并加上索引。这是空间换时间的经典 trade-off。
crm_activity 表,通常是 CRM 里增长最快的表。电话、邮件、拜访、微信聊天记录,全往里塞。
设计这张表,最大的坑在于“关联关系”。
一条跟进记录,可能关联客户,可能关联商机,也可能关联合同。
如果是外键 customer_id, opportunity_id, contract_id 全放在一张表里,大部分字段都是 NULL,浪费空间且索引效率低。
推荐方案:
采用“多态关联”或者“关联子表”。
考虑到查询性能,我倾向于在 crm_activity 主表里保留 target_type(对象类型)和 target_id(对象 ID)。
target_type 存枚举值,比如 1 代表客户,2 代表商机。
虽然这违反了第三范式,但在读取“某客户的所有跟进记录”时,效率最高。
另外,跟进内容 content 字段,千万别用 TEXT 类型放在主表里,除非你确定不会经常查它。
更好的做法是:主表存摘要 summary(VARCHAR 255),详细内容存 crm_activity_detail 表,或者干脆存到 Elasticsearch 里。
销售列表页只需要看摘要和跟进时间,只有点进去详情才加载全文。这样能大幅减少数据库的 IO 压力。
还有一个细节:owner_id(负责人)。
跟进记录必须记录“是谁跟进的”,而不是“客户属于谁”。因为销售可能会离职,客户会公海池流转,但历史跟进记录必须保留原始操作人的 ID,用于业绩追溯和纠纷定责。这个字段一旦写入,禁止修改。
CRM 的权限系统比一般后台复杂得多。 普通后台是“菜单权限”,CRM 是“数据权限”。 销售 A 只能看自己的客户,销售主管能看全组的,大区经理能看全区的。
在数据库层面,不要试图用视图(View)来解决,维护成本太高。
最稳妥的方式是在应用层做 SQL 拦截,或者在每张核心表里都加上 data_scope_path(数据范围路径)。
比如:001.005.012 代表 总部。华东区。上海分公司。
查询时,用 LIKE '001.005.%' 就能查出上海分公司及其下属的数据。
这比递归查询组织架构表要快得多。
关于公海池(High Seas),其实就是把 owner_id 设为 NULL 或者特定 ID 的数据。
但这里有个逻辑陷阱:客户掉入公海的规则。
是 30 天没跟进?还是 90 天没成交?
别把这套逻辑写死在代码里。建议设计一张 crm_pool_rule 表,配置规则。
数据库里加个 last_active_time 字段,每次跟进更新一次。
定时任务扫描:UPDATE crm_account SET owner_id = NULL WHERE last_active_time < NOW() - INTERVAL 30 DAY AND owner_id IS NOT NULL;
注意,这条更新语句在数据量大时会锁表。务必分批处理,或者走从库分析,主库执行。
CRM 系统用个两年,数据量轻松过千万。
这时候,SELECT * FROM crm_activity 简直就是自杀。
设计之初就要考虑“冷热分离”。
在核心表里加 is_archived 字段,或者按年份分表。
我个人更推荐“归档表”策略。
主表 crm_activity 只保留最近一年的数据。
一年前的数据,迁移到 crm_activity_history_2022,crm_activity_history_2023。
前端查询时,默认查主表,用户如果点击“查看历史记录”,再查归档表。
这样能保证核心业务永远轻快。
索引设计也有讲究。 别盲目加索引。CRM 的查询场景很固定:
idx_owner_status)。idx_create_time)。
除了这几种,其他冷门查询,让运营去导 Excel 慢慢跑,别为了 1% 的场景拖累 99% 的性能。还有一个容易被忽略的点:软删除(Soft Delete)。
CRM 里数据很敏感,销售误删了客户是大事故。
所以每张表都要有 deleted_at 字段。
但是,查询的时候,务必在 ORM 层全局加上 WHERE deleted_at IS NULL。
千万别指望开发每次写 SQL 都记得加。一旦漏加,回收站的数据混进来,报表就全错了。
另外,deleted_at 字段不要建普通索引,因为大部分是 NULL,索引区分度低。如果查询回收站频率高,可以建个部分索引。
现在做 CRM,不考虑 GDPR 或者国内的《个人信息保护法》,迟早要出事。
数据库里存手机号,不能明文。
设计时,mobile 字段存加密后的密文。
但加密了怎么搜索?
方案是:再建一个 mobile_hash 字段,存手机号的 SHA256 值。
搜索时,先算哈希,再查库。
虽然不能模糊搜索手机号(比如搜 138),但这是合规的代价。
如果业务强依赖模糊搜索,那只能退一步,存前 3 后 4 位明文,中间掩码。但这需要法务确认风险。
密码、身份证、银行卡号,同理。
另外,操作日志 crm_operation_log 必须独立存储,且不可篡改。
谁在什么时间,把客户 A 的电话从 139 改成了 138,这条日志要永久保存。
这不仅是审计需求,也是发生数据泄露时定责的唯一依据。
日志表建议采用 Append Only 策略,禁止 Update 和 Delete。
最后,分享几个我在代码 Review 时经常指出的小问题,看似不起眼,实际影响很大。
金额字段用 Decimal 还是 BigInt? 别无脑用 Decimal。如果涉及多币种换算,Decimal 的精度丢失和性能问题很头疼。 建议统一存“分”,用 BigInt。展示时再除以 100。 这样避免了浮点数计算误差,也方便做整型索引。
时间字段存 Timestamp 还是 DateTime? 如果业务涉及跨国,必须存 UTC 时间(Timestamp 或 DateTime + 时区字段)。 展示时根据用户时区转换。 千万别存“北京时间”,否则你的系统出海时,时区逻辑会让你重构到怀疑人生。
枚举值用数字还是字符串? 表结构里用 TinyInt 存状态(1: 跟进中,2: 已成交),节省空间。 但在代码层和 API 返回层,必须映射为字符串('IN_PROGRESS', 'WON')。 数据库里别存中文“跟进中”,万一编码变了,或者要支持多语言,全是乱码。
版本号字段 version
在 crm_account 等核心表加一个 version 字段,每次更新 +1。
这是为了做乐观锁。
两个销售同时编辑同一个客户信息,后提交的人应该被提示“数据已变更,请刷新”。
没有这个字段,后提交的会直接覆盖先提交的,导致数据丢失,这是销售最恨的 Bug 之一。
CRM 数据库设计,本质上是在平衡“灵活性”与“规范性”。 太规范,业务改不动;太灵活,数据变成垃圾场。 没有完美的设计,只有最适合当前业务阶段的设计。 刚开始做,别搞太复杂,把客户、联系人、商机这三张表的关系理顺,加上必要的索引和日志,就能跑起来。 等业务量上来了,再考虑分库分表、ES 检索、数据仓库同步。
记住,数据库是系统的基石。基石歪了,上面盖再漂亮的 UI,做再智能的 AI 推荐,都是空中楼阁。 下次设计表结构前,先别急着画 ER 图,去找销售聊聊天,问问他们平时最头疼什么,最怕系统卡在哪里。 往往最好的设计灵感,不在技术文档里,而在销售抱怨的声音里。
这行干久了就明白,技术是为业务服务的。能帮销售多签单、少加班的数据库设计,才是好设计。至于用了什么范式,上了什么新技术,那都是次要的。希望这些踩坑经验,能帮你少加点班,多睡会儿觉。
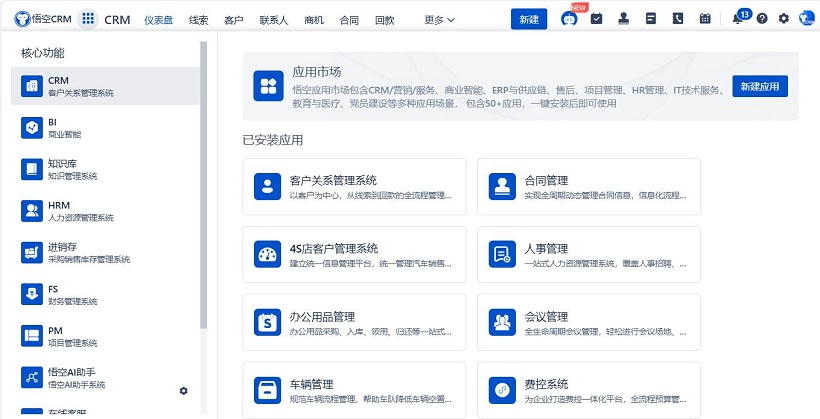
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
 客服电话
 售前咨询


